

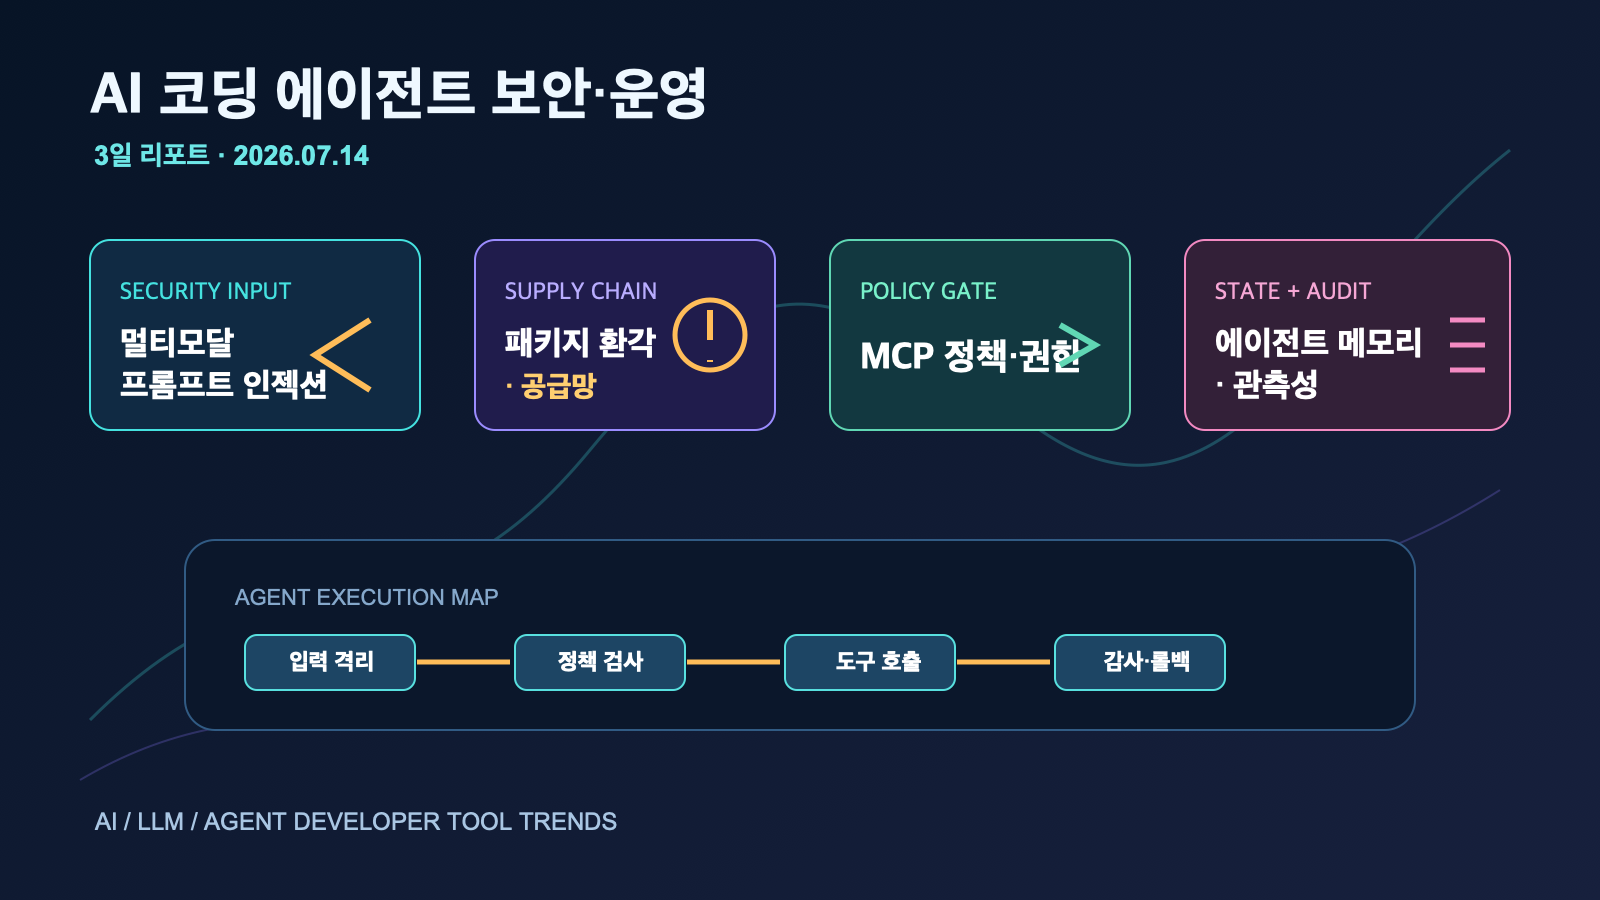
요약: 2026년 7월 11일~14일(한국 시간) AI/LLM·AI 에이전트 개발자 도구의 3일 흐름은 멀티모달 입력을 통한 프롬프트 인젝션, AI가 만든 패키지명으로 인한 공급망 위험, MCP 권한 정책, 에이전트 상태·관측성으로 수렴한다. AI 코딩 에이전트를 도입하는 팀은 생성 품질만 비교하지 말고 입력 검증·도구 권한·의존성 검증·감사 로그를 하나의 배포 기준으로 운영해야 한다.
핵심 답변: 이번 3일 동안 무엇을 먼저 바꿔야 하나?
답: 에이전트가 읽는 모든 외부 콘텐츠를 비신뢰 입력으로 취급하고, 패키지 설치·파일 변경·네트워크 호출을 최소 권한과 재현 가능한 승인 흐름 뒤로 보내야 한다. 최근 보도는 이미지에 숨긴 지시가 코드 리뷰 도구에 영향을 줄 수 있는 GhostCommit 사례와, AI가 제안한 존재하지 않는 라이브러리 이름이 공격자 패키지로 이어질 수 있다는 slopsquatting 보도를 동시에 보여 줬다.
- 확인된 사실: 7월 13일 보도에서 이미지 속 악성 AI 지시와 AI 코딩 도구가 만드는 패키지 환각·공급망 문제가 각각 제기됐다.
- 확인된 사실: 같은 기간 MCP 하드닝 논의는 위협 탐지와 정책 집행을 연결 계층의 핵심 과제로 다뤘다.
- 해석: 에이전트의 다음 병목은 모델 성능만이 아니라 실행 전후의 통제·상태 관리·증적 품질이다.
3일 결론: 에이전트의 공격 표면과 운영 표면이 같은 그래프가 됐다
이번 기간의 신호를 한 문장으로 정리하면, AI 코딩 에이전트는 “코드를 제안하는 인터페이스”에서 “외부 입력을 읽고, 도구를 호출하며, 상태를 저장하는 실행 시스템”으로 이동하고 있다. 이 변화는 보안팀에는 공급망·권한·감사 범위의 확장을, 플랫폼 팀에는 모델 외부의 정책·메모리·관측성 인프라를 요구한다. 아래의 시사점은 개별 보도의 기능 보장을 뜻하지 않으며, 확인된 사건·발표를 바탕으로 한 운영 권고다.
흐름 1. 이미지와 패키지명이 에이전트 공급망의 새 입력 경로가 됐다
사실 → 근거 → 시사점
사실: Malwarebytes는 7월 13일 이미지에 숨긴 악성 지시가 AI 코드 리뷰 도구를 겨냥하는 GhostCommit 공격을 보도했다. VentureBeat도 같은 날 AI 코딩 도구가 만들어 낸 잘못된 패키지명을 악성 패키지 등록에 악용할 수 있는 slopsquatting을 공급망 위험으로 다뤘다. 근거: 두 보도 모두 에이전트가 자연어·이미지·의존성 이름을 처리하는 경로가 공격자에게 입력면이 될 수 있음을 설명한다. 시사점: “모델이 코드를 잘 쓰는가”라는 평가만으로는 부족하며, 입력 출처와 설치 대상의 검증이 CI 정책이 되어야 한다.
특히 이미지·스크린샷·README·이슈·문서에서 추출된 텍스트는 신뢰 경계 밖에 있다. 에이전트에 “이 지시를 실행하라”는 문장을 숨기는 방식은 도구가 멀티모달 입력을 읽을수록 더 현실적인 위협 모델이 된다. 패키지명도 마찬가지다. 모델이 그럴듯한 이름을 제안했다는 사실은 레지스트리 존재, 게시자, 서명, 최근 유지보수, 잠긴 해시를 보장하지 않는다.
- 에이전트가 외부 콘텐츠를 읽는 단계와 셸·패키지 관리자를 호출하는 단계를 분리한다.
- 새 의존성은 허용 목록, lockfile, 레지스트리 존재 확인, 취약점·서명 검사 없이 자동 설치하지 않는다.
- CI에서 패키지명 오타·신규 게시자·비정상적으로 새 패키지에 경고를 건다.
- 이미지 OCR·비전 입력의 지시문은 데이터로 취급하고 도구 호출의 근거로 직접 승격하지 않는다.
흐름 2. MCP의 실무 과제는 연결 수가 아니라 정책 집행과 최소 권한이다
사실: 7월 13일 MCP 하드닝 보도는 고급 위협 탐지와 정책 집행을 함께 제시했다. 근거: MCP는 모델과 도구·데이터를 연결하므로 서버의 도구 설명, 인자, 반환값, 자격증명 범위가 모두 실행 경계에 속한다. 시사점: MCP 도입의 KPI를 “연결한 서버 수”로 두면 위험이 가려지고, 서버별 허용 도구·데이터 분류·네트워크 범위·감사 이벤트를 코드화해야 한다.
구체적으로는 읽기 전용 검색, 티켓 생성, 저장소 쓰기, 배포처럼 위험도가 다른 도구를 하나의 토큰으로 묶지 않는 것이 출발점이다. 고위험 호출에는 정규화된 인자, 대상 리소스, 정책 판정, 승인자, 결과 해시를 남겨야 한다. 그렇게 해야 프롬프트나 모델을 바꾼 뒤에도 어떤 도구 경로가 품질 저하나 보안 예외를 만들었는지 추적할 수 있다.
MCP 운영 체크리스트
- 서버마다 서비스 계정과 최소 권한을 분리한다.
- 허용된 도구 이름·인자 스키마·도메인을 정책 파일에서 검증한다.
- 개발·CI·운영 환경의 자격증명과 네트워크 egress를 분리한다.
- 도구 호출 그래프와 거부된 정책 결정을 비밀값 없이 보존한다.
흐름 3. 메모리·지속성은 채팅 편의가 아니라 재현성과 관측성의 기반이 된다
사실: Oracle은 7월 13일 LangChain 생태계의 메모리, 지속성, Deep Agents를 데이터베이스 계층과 연결하는 내용을 공개했다. 근거: 공식 Oracle 블로그 공지는 에이전트의 상태를 지속 가능한 데이터 계층과 묶는 흐름을 보여 준다. 시사점: 팀은 긴 대화 이력을 보존하는 것보다, 어떤 사실·도구 결과·정책 결정을 어떤 수명과 접근권한으로 보관할지를 설계해야 한다.
상태 저장소에는 사용자 데이터·비밀·임시 추론·승인 기록이 섞이기 쉽다. 따라서 메모리 스키마에 출처, 생성 시각, TTL, 민감도, 삭제 정책, 사용한 에이전트 버전을 넣고, 재실행 시 어떤 상태가 재사용됐는지 추적해야 한다. 이것은 개인정보·비밀 노출을 줄이는 동시에 실패한 실행을 재현하고 롤백하는 데도 필요하다.
흐름 4. 생산성 지표는 늘어도 검증 비용을 함께 계산해야 한다
사실: TechRepublic은 7월 13일 Microsoft 연구를 인용해 AI 코딩 에이전트가 pull request를 24% 높였다고 보도했다. 근거: 해당 보도는 PR 수 증가를 생산성 신호로 제시한다. 시사점: 이 수치는 특정 연구·상황의 결과이며 일반적인 품질 보증이 아니다. 팀은 산출량과 함께 리뷰 리드타임, 테스트 통과율, 되돌림, 보안 예외, 작업당 총비용을 측정해야 한다.
에이전트가 작은 변경을 더 많이 만들면 PR 수는 증가할 수 있다. 반대로 사람이 변경의 맥락을 복원하는 시간이 길어지면 순생산성은 떨어질 수 있다. 따라서 대표 작업 10~20개로 평가 세트를 만들고, 동일한 권한·테스트·모델 설정에서 결과를 비교하는 방식이 안전하다. 이때 “사람이 수정 없이 수용한 비율”과 “실패 시 자동 롤백 가능 여부”를 핵심 지표에 넣으면 단순 처리량 지표의 왜곡을 줄일 수 있다.
개발자 액션 플랜: 다음 스프린트의 5가지 우선순위
- 비신뢰 입력 격리: 외부 이미지·문서·이슈를 읽는 에이전트를 코드 실행 환경과 분리한다.
- 의존성 검증 자동화: AI가 제안한 패키지는 registry 존재·게시자·lockfile·해시를 검사한 뒤에만 설치한다.
- MCP 권한 인벤토리: 서버별 도구, 데이터, 토큰, 네트워크 경로와 승인 규칙을 표로 만든다.
- 상태 데이터 계약: 메모리에 저장되는 항목의 TTL·민감도·삭제·감사 규칙을 정한다.
- 실제 업무 평가: PR 수가 아니라 테스트·리뷰·재작업·보안 예외·비용을 함께 수집한다.
FAQ: AI 코딩 에이전트를 안전하게 확장하려면?
Q. 프롬프트 인젝션을 막으려면 프롬프트만 강화하면 되나?
A. 아니다. 프롬프트 지침은 한 층일 뿐이다. 입력 격리, 도구 권한 축소, 네트워크 제한, 승인 단계, 실행 로그가 함께 있어야 방어가 된다.
Q. MCP 서버를 많이 연결하면 에이전트가 더 유용해지지 않나?
A. 유용성은 늘 수 있지만 권한 그래프도 넓어진다. 연결 전에 데이터 분류와 허용 도구를 정하고, 고위험 작업은 별도 서버·서비스 계정·사람 승인으로 분리하는 편이 낫다.
Q. 생산성은 가장 간단히 어떻게 측정하나?
A. 동일한 대표 작업에서 수용된 변경 비율, 테스트 통과율, 리뷰 시간, 재시도, 롤백, 작업당 비용을 모델·도구·권한 정책별로 비교한다. PR 개수는 보조 지표로만 사용한다.
출처 및 확인 방법
- Malwarebytes — Ghostcommit attack hides malicious AI instructions in images (7월 13일)
- VentureBeat — slopsquatting and AI coding tools (7월 13일)
- Security Boulevard — Hardening MCP (7월 13일)
- Oracle Blog — LangChain memory, persistence, Deep Agents (7월 13일)
- TechRepublic — Microsoft study on AI coding agents and PRs (7월 13일)
편집 원칙: 사실은 링크된 공지·보도를 기준으로 정리했다. 운영 시사점과 액션은 이를 바탕으로 한 편집 해석이며, 제품의 지원 범위·연구 수치·보안 영향은 도입 전에 원문과 공급자 최신 공지를 재확인해야 한다.
더 깊게 읽기: 실전 가이드
이 리포트는 최근 흐름을 빠르게 파악하기 위한 요약입니다. 실제 프로젝트에 적용할 때는 아래의 기준 글과 함께 확인하면 더 안전합니다.