

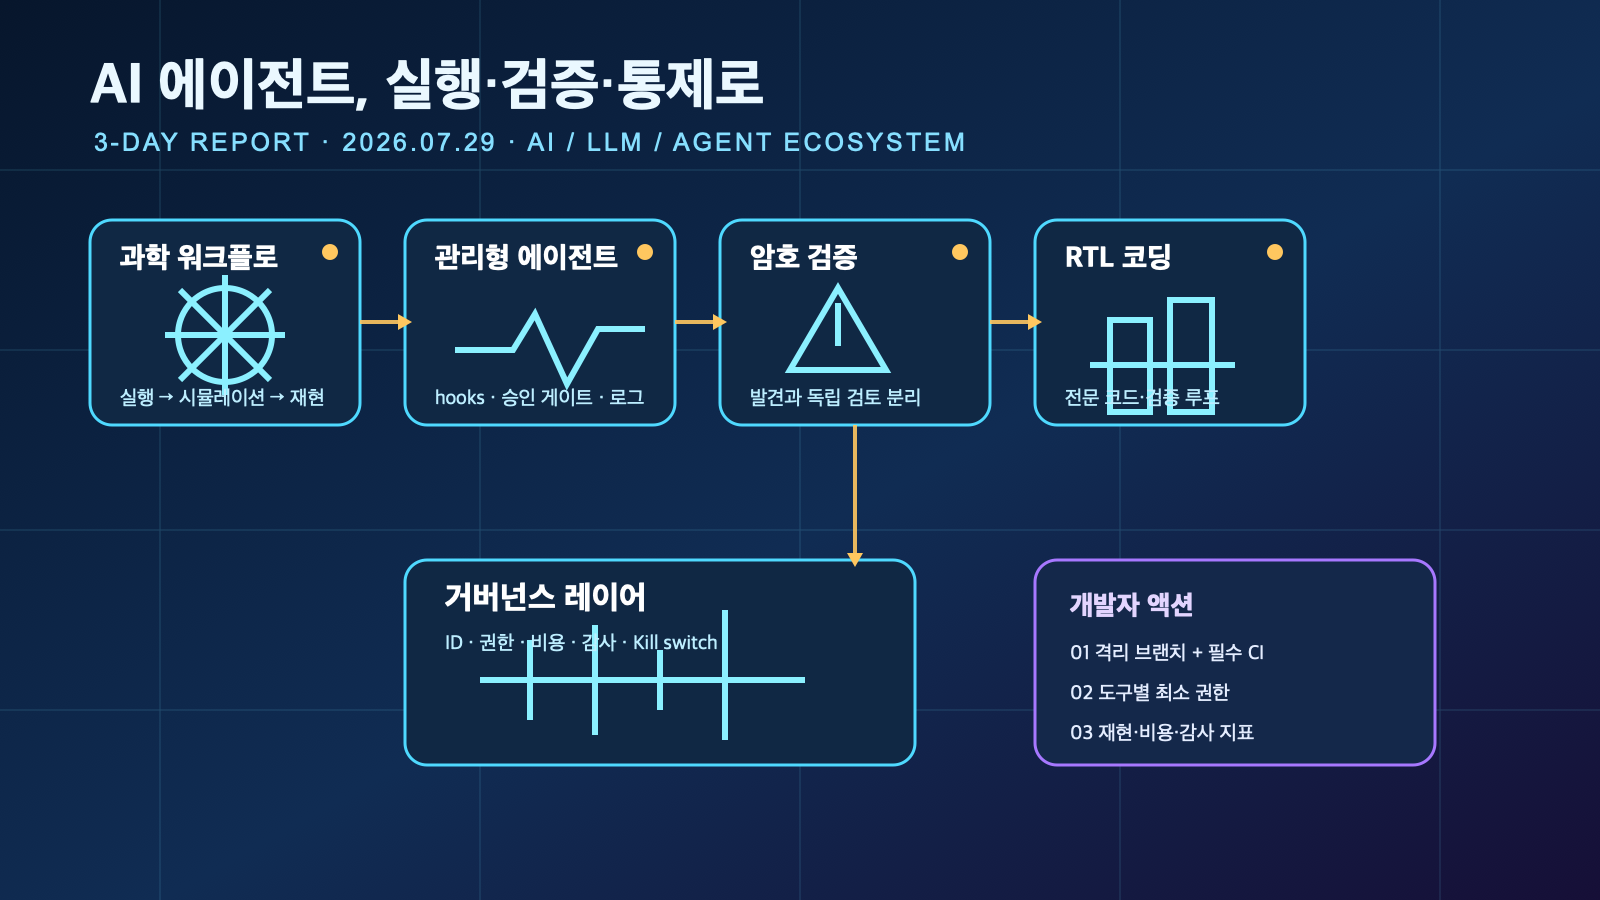
핵심 답변: 2026년 7월 27~29일의 AI/LLM/AI Agent 흐름은 에이전트가 단순한 대화형 보조 도구에서 과학 계산·전문 코드 작성·보안 검증처럼 검증 비용이 높은 실행 작업으로 이동하는 동시에, 관리형 실행·도구 hooks·게이트웨이 관찰성으로 통제 계층을 갖추는 방향을 보여준다. 개발팀의 우선순위는 새 모델을 기본값으로 바꾸는 일이 아니라, 에이전트가 무엇을 읽고·호출하고·수정하고·승인받는지 작업 단위로 증명하는 것이다.
요약: 이번 3일 리포트는 AI 에이전트, 관리형 에이전트, 암호 검증, RTL 코딩, AI 거버넌스의 다섯 이슈를 세 흐름으로 묶는다. 확인된 발표는 출처 링크로 구분했고, 그로부터 도출한 개발·운영 권고는 별도의 실무 해석으로 표시한다.
3일 결론: ‘더 오래 실행하는 에이전트’가 늘수록 품질은 모델 이름보다 입력 경계, 권한 분리, 재현 가능한 검증, 비용·감사 로그에 좌우된다. 먼저 낮은 위험도의 조사·테스트·문서 작업에서 관측 지표를 만들고, 그 뒤 제한된 코드 변경으로 확장하는 편이 안전하다.
72시간 핵심 이슈: 무엇이 확인됐나
- OpenAI: 7월 28일 Scientific computing in the age of agentic AI를 공개했다. 제목과 공식 발표가 가리키는 핵심은 과학 계산을 에이전트형 AI의 적용 영역으로 다룬다는 점이다.
- Google: 7월 28일 Gemini API Managed Agents: 3.6 Flash, hooks, and more를 발표했다. 관리형 에이전트와 hooks가 개발자 API의 핵심 주제라는 사실이 확인된다.
- Anthropic: 7월 28일 Discovering cryptographic weaknesses with Claude를 공개했다. 에이전트/모델 활용이 암호 알고리즘 검증 사례까지 확장되고 있음을 보여준다.
- NVIDIA: 7월 27일 Nemotron 3 Ultra의 agentic RTL coding 사례를 게시했다. RTL 개발·검증은 전문 지식과 긴 피드백 루프가 필요한 영역이다.
- Snowflake: 7월 28일 보도와 Cortex AI Gateway 공식 안내는 기업 에이전트의 접근, 거버넌스, 비용 통제를 전면에 둔다. 제품의 실제 사용 가능 범위와 계약 조건은 도입 전 공식 문서·콘솔에서 별도 확인해야 한다.
사실과 해석의 구분: 위 항목의 발표 제목·날짜·주제는 1차 출처 기준이다. ‘전문 작업 확대’와 ‘통제 계층의 중요성’은 이 발표들을 함께 읽어 도출한 편집 해석이며, 특정 모델의 정확도·비용·보안성을 보증하는 말이 아니다.
흐름 1: 에이전트의 무대가 ‘채팅’에서 전문 실행 워크플로로 넓어진다
과학 계산과 RTL 코딩은 같은 질문을 던진다
OpenAI의 과학 계산 발표와 NVIDIA의 agentic RTL coding 사례는 서로 다른 도메인이지만 공통점이 있다. 둘 다 한 번의 답변보다 가설 설정 → 도구 실행 → 결과 비교 → 수정 → 재검증의 반복이 중요하다. 특히 RTL은 설계와 검증이 맞물리며, 과학 계산은 데이터·가정·재현 조건이 결론의 일부가 된다. 따라서 에이전트가 제안한 결과를 ‘그럴듯한 설명’으로 끝내면 안 되고, 입력 버전·실행 환경·명령·산출물을 함께 보관해야 한다.
실무 영향: 전문 도메인 에이전트의 성공 지표를 채팅 만족도나 PR 개수로 잡으면 위험하다. 코드·모델·데이터·시뮬레이터가 묶인 검증 패키지, 실패한 가설의 로그, 사람이 확인한 acceptance criteria를 만들어야 한다. 이는 공식 발표의 기능 설명을 넘어선 운영 권고다.
개발자가 바로 적용할 최소 단위
- 에이전트 작업을 ‘조사’, ‘재현’, ‘패치 제안’, ‘변경’, ‘배포’ 다섯 단계로 나누고 단계별 토큰·도구·쓰기 권한을 다르게 둔다.
- 전문 코드 작업의 PR 템플릿에 입력 버전, 재현 명령, 테스트 결과, 변경하지 않은 경계, 롤백 방법을 필수 항목으로 둔다.
- 10개 내외의 대표 작업으로 사람 단독 경로와 비교해 CI 통과율, 재실행 횟수, 리뷰 수정률, p95 실행 시간, 총 비용을 수집한다.
흐름 2: 관리형 에이전트와 hooks는 ‘도구 호출 계약’을 제품화한다
관리형이라는 말이 자동 승인을 뜻하지는 않는다
Google의 Managed Agents 및 hooks 발표는 에이전트 실행을 애플리케이션 안에 조립하는 개발자 경험이 중요해지고 있음을 시사한다. 여기서 hooks는 모델의 텍스트 출력만 받는 구조보다, 실행 전후에 정책·검사·관찰을 연결할 수 있는 접점으로 해석할 수 있다. 다만 발표 제목만으로 특정 hook의 동작, 권한 모델, 가격, 모든 지역에서의 가용성을 일반화해서는 안 된다. 구현 시점의 API 문서와 릴리스 노트를 다시 확인해야 한다.
실무 영향: 좋은 agent integration은 ‘도구를 많이 연결한 앱’이 아니라 ‘각 도구 호출에 주체·목적·범위·승인·결과가 남는 앱’이다. GitHub, 데이터베이스, 티켓, 브라우저, 사내 API를 한 에이전트에게 한꺼번에 열기 전에 도구별 allowlist와 최대 영향 범위를 선언해야 한다.
권한 설계 체크리스트
- 입력: 외부 이슈·웹 문서·첨부 파일의 명령을 신뢰할 수 없는 데이터로 처리하고, 시스템 지시와 분리한다.
- 도구: 읽기 전용과 변경 도구를 분리하며, 삭제·결제·배포·비밀 접근은 사람의 명시적 승인 토큰 없이는 호출하지 않는다.
- 실행: 브랜치·컨테이너·서비스 계정을 작업마다 격리하고, 기본 권한은 최소화한다.
- 출력: 에이전트의 완료 문장 대신 diff, 테스트 로그, 정책 판정, 승인자를 감사 가능한 결과물로 남긴다.
흐름 3: 보안 검증과 기업 거버넌스가 에이전트 도입의 동반 조건이 된다
암호 취약점 탐색은 ‘발견’과 ‘확정’을 분리하라는 신호다
Anthropic의 암호 취약점 탐색 사례는 모델이 사람이 오래 걸리는 탐색을 보조할 수 있음을 보여준다. 그러나 보안 이슈에서 모델의 제안은 취약점 확정이 아니다. 독립 재현, 영향 범위 분석, 책임 있는 공개 절차, 사람 전문가의 검토가 이어져야 한다. 특히 내부 보안 도구에 에이전트를 붙일 때는 공격 문자열과 비신뢰 입력이 도구 사용을 조작하지 못하도록 별도의 경계가 필요하다.
게이트웨이는 비용 대시보드 이상의 역할을 해야 한다
Snowflake의 Cortex AI Gateway 관련 공개 흐름은 기업 환경에서 접근 제어·거버넌스·비용 관찰이 하나의 문제로 묶이고 있음을 보여준다. 이 글은 특정 공급자의 모든 기능을 보증하지 않는다. 다만 실무적으로는 모델 provider별 사용량만 보는 대시보드보다, 사용자/에이전트 ID → 도구 호출 → 데이터 범위 → 승인 → 비용 → 결과를 연결해 추적할 수 있어야 한다. 그래야 비정상 재시도, 권한 확대, 예상 밖 데이터 접근을 같은 사건으로 조사할 수 있다.
권고: 작업당 예산 상한, 도구 호출 횟수 상한, 네트워크 egress 규칙, 민감 경로 차단, kill switch를 운영 정책에 넣는다. 이는 위 공개 흐름을 바탕으로 한 방어적 설계 권고이며, 공급자 설정만으로 자동 충족되는 요구사항은 아니다.
개발자 액션 플랜: 이번 주에 할 일
- P0 — 인벤토리: 운영·개발 환경의 agent runner, 모델 provider, MCP/도구 서버, 서비스 계정, 쓰기 가능한 데이터·저장소를 한 장의 표로 정리한다.
- P0 — 경계: 보호 브랜치와 배포 파이프라인에서 에이전트의 직접 push·자동 merge·비밀 읽기를 차단하고, CI와 CODEOWNERS를 필수화한다.
- P1 — 관측: 요청 ID를 모델 호출, tool call, PR, 비용, 승인 로그에 공통으로 넣고 오류·재시도·차단 이벤트를 대시보드에서 분리한다.
- P1 — 평가: 과학/전문 코드처럼 긴 작업은 작은 canary 집합에서만 시험하고, 정답률뿐 아니라 재현 가능성과 사람 검토 시간을 비교한다.
- P2 — 사고 대응: 도구 차단·세션 폐기·자격 증명 회전·브랜치 폐기·롤백을 포함한 15분 대응 절차를 리허설한다.
FAQ
관리형 AI 에이전트를 쓰면 보안·감사는 공급자가 해결해 주나?
아니다. 관리형 서비스는 운영 부담을 줄일 수 있지만, 어떤 데이터와 도구를 연결할지, 어떤 계정으로 실행할지, 변경을 누가 승인할지는 사용 조직의 책임이다. 제품별 권한 모델과 로그 보존 범위를 도입 전에 확인해야 한다.
전문 코드나 보안 검증에 에이전트를 바로 투입해도 되나?
낮은 위험도의 조사·테스트 생성·재현 보조부터 시작하는 편이 좋다. 취약점 확정, 설계 승인, production 변경은 독립 재현과 담당자 검토를 통과해야 한다. 에이전트의 답변은 증거가 아니라 검증할 가설로 다룬다.
가장 먼저 측정할 지표는 무엇인가?
작업 성공률 하나가 아니라 CI 통과율, 재실행 횟수, 사람 리뷰 수정률, 도구별 실패·차단율, 작업당 비용, 롤백 여부를 함께 본다. 이 조합이 품질·안전·경제성을 동시에 드러낸다.
출처 및 추가 읽기
- OpenAI — Scientific computing in the age of agentic AI (2026-07-28)
- Google — Gemini API Managed Agents: 3.6 Flash, hooks, and more (2026-07-28)
- Anthropic — Discovering cryptographic weaknesses with Claude (2026-07-28)
- NVIDIA Technical Blog — Nemotron 3 Ultra and agentic RTL coding (2026-07-27)
- Snowflake — Cortex AI Gateway (access/feature scope should be verified in current official documentation)
편집 원칙: 발표 제목·날짜·공개 주제는 각 1차 출처를 기준으로 했다. 실무 영향, 권한 설계, 관측·검증 절차는 이를 바탕으로 한 보수적 운영 해석이며 각 조직의 정책과 최신 문서로 검증해야 한다.
더 깊게 읽기: 실전 가이드
이 리포트는 최근 흐름을 빠르게 파악하기 위한 요약입니다. 실제 프로젝트에 적용할 때는 아래의 기준 글과 함께 확인하면 더 안전합니다.