

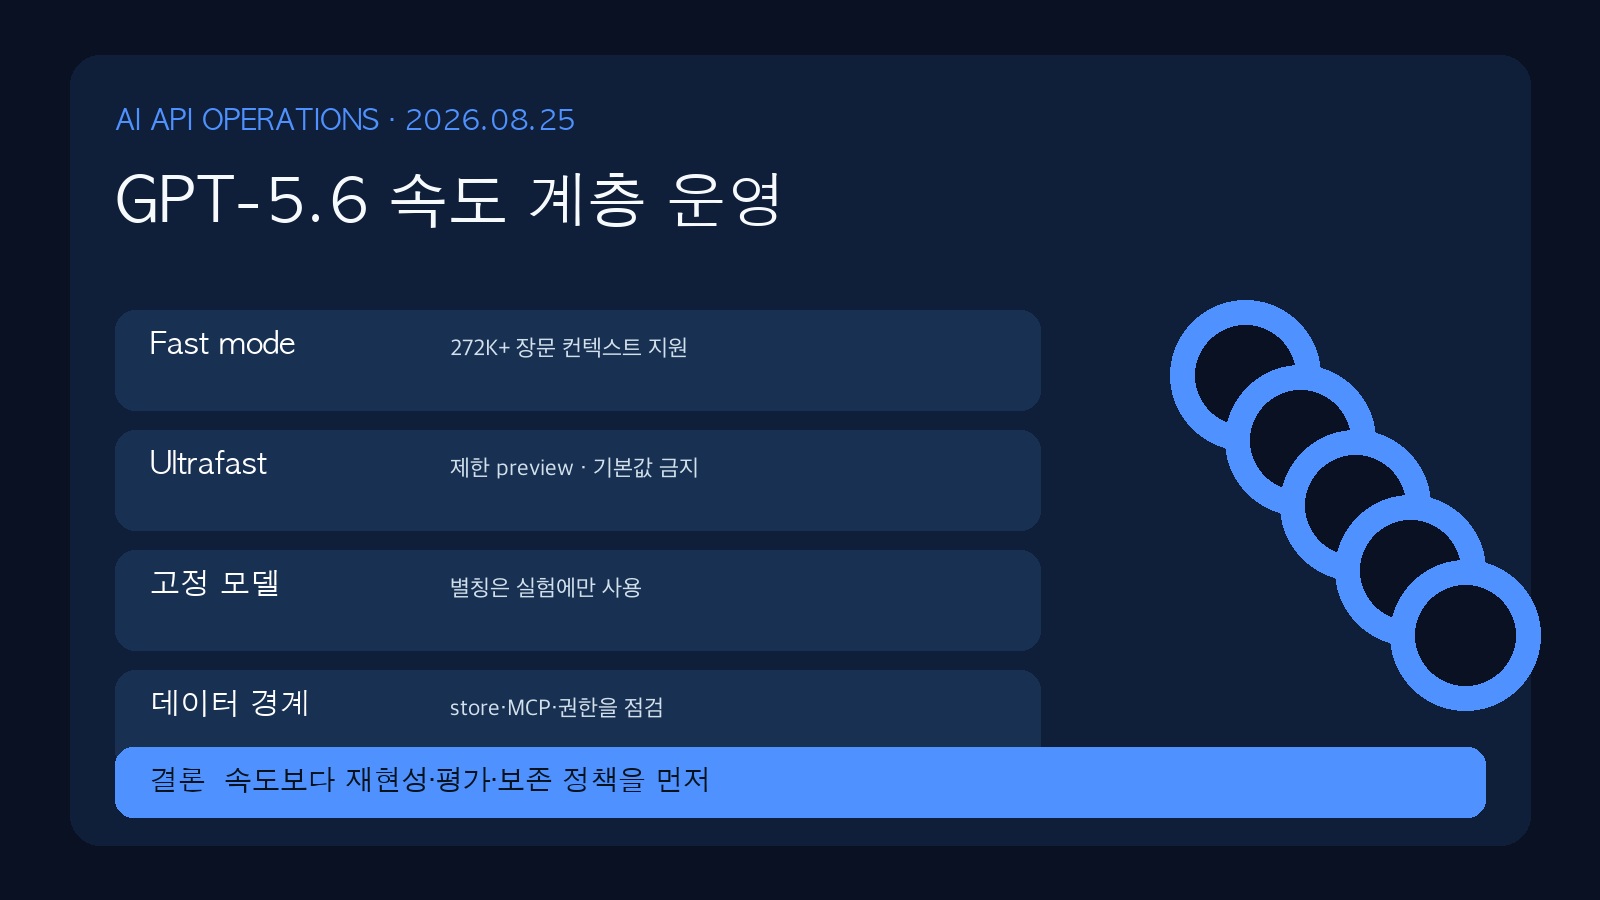
핵심 답변: 2026년 8월 OpenAI API의 변화는 “더 빠른 모델을 켜는 일”보다 지연 시간·비용·데이터 보존·권한을 요청 단위로 분리해 운영하는 일을 요구한다. OpenAI는 8월 5일 GPT-5.6 Sol·Terra·Luna의 272K 토큰 초과 장문 컨텍스트에서도 Fast mode를 지원한다고 공지했고, 8월 13일에는 GPT-5.6 Sol의 Ultrafast mode를 제한된 고객 대상으로 미리보기 제공한다고 발표했다. 동시에 8월 6일 chat-latest 스냅샷을 갱신하면서도 프로덕션 API에는 특정 GPT-5.6 Sol 모델을 권고했다.
Nuxt 프론트엔드 팀에게 이는 특히 중요하다. 대형 저장소 분석, SSR 장애 조사, 코드 리뷰 보조처럼 오래 기다려도 되는 작업과 사용자가 버튼을 누른 뒤 즉시 반응해야 하는 작업은 같은 서비스 등급이나 모델 별칭으로 묶으면 안 된다. 빠른 경로를 추가하기 전에 각 요청의 모델 ID, service tier, 토큰, 실패율, 보존 조건을 추적해야 비용 절감이 기능 퇴행이나 데이터 정책 위반으로 바뀌지 않는다.
오늘의 결론: 모델 별칭 chat-latest는 실험용으로만 두고, 운영 에이전트는 고정된 모델·명시된 지연 등급·최소 권한 도구·평가 세트를 하나의 배포 단위로 관리하자. Fast/Ultrafast의 “최대” 속도 수치는 자신의 Nuxt 작업에서 보장된 SLO가 아니다.
무슨 일이 있었나
2026년 8월 5일, OpenAI API Changelog: GPT-5.6 Sol, Terra, Luna에서 272K 토큰을 초과하는 long-context 요청도 Fast mode로 실행할 수 있으며, Standard 대비 최대 2.5배 속도를 안내했다. 이는 API의 처리 등급 변화이며 모든 프롬프트가 같은 체감 지연을 갖는다는 뜻은 아니다.
2026년 8월 6일, OpenAI: chat-latest 스냅샷이 갱신됐다. 공식 문서는 이 별칭이 ChatGPT Plus/Pro의 최신 모델을 가리키고 정기적으로 변경된다고 설명하며, 생산 API에는 GPT-5.6 Sol 사용을 권한다. 2026년 8월 13일에는 GPT-5.6 Sol Ultrafast mode를 Standard 대비 최대 14배 속도의 제한 미리보기로 발표했다.
운영 전제: 데이터 제어 문서에 따르면 API 데이터는 기본적으로 모델 학습에 사용되지 않지만, abuse monitoring log와 기능별 application state는 별도 보존 규칙을 가진다. Responses API는 기본 또는 store=true일 때 응답 데이터를 최소 30일 저장할 수 있고, ZDR에서는 store가 false로 처리된다. 따라서 속도 옵션은 데이터 경로 검토를 대체하지 않는다.
왜 중요한가
확인된 사실: Fast mode의 장문 컨텍스트 지원과 Ultrafast limited preview가 공식 발표됐고, chat-latest는 변하는 스냅샷이다. 해석: 팀은 “모델 선택”을 코드 상수 하나가 아니라 workload routing 정책으로 다뤄야 한다. 즉시 응답 UI, 비동기 저장소 조사, 야간 배치 평가에 서로 다른 예산과 실패 처리 규칙이 필요하다. 불확실성: 최대 속도는 고객·가용성·입력 길이·도구 호출·큐 상태별 실제 p95를 뜻하지 않으며 Ultrafast는 누구나 사용할 수 있는 GA 기능이 아니다.
에이전트가 nuxt.config.ts, server route, 배포 환경 설명을 동시에 읽는다면 긴 컨텍스트는 재검색을 줄일 수 있다. 반면 프롬프트에 빌드 로그, 고객 식별자, 환경 변수 값을 무분별하게 넣으면 지연을 줄이려다 보존·접근 범위를 넓힌다. 성능 실험은 반드시 비밀을 제거한 fixture 저장소와 재현 가능한 작업으로 시작해야 한다.
1. Fast mode 장문 컨텍스트는 “더 많이 넣기”가 아니라 작업 분리의 신호다
변경 내용: 8월 5일부터 GPT-5.6 계열의 272K 토큰 초과 요청도 Fast mode 대상이다. 실제 영향: 모노레포의 라우트·컴포넌트·테스트·문서 간 관계를 한 세션에서 확인하는 탐색 작업의 대기 시간을 줄일 후보가 된다. 적용/회피 조건: 사용자 요청을 처리하는 SSR 경로에는 무제한 컨텍스트를 붙이지 말고, 비동기 분석 큐로 분리한다. 입력은 allowlist한 파일과 요약 인덱스로 제한하며 .env, lockfile 내 토큰, 운영 로그 원문은 제외한다. 검증 방법: 같은 10개 Nuxt 결함에서 Standard/Fast의 p50·p95, 입력/출력 토큰, 도구 호출 수, 테스트 통과율, 사람 수정량을 기록한다. 속도만 빨라지고 수정 diff가 커지면 채택 근거가 아니다.
2. Ultrafast preview는 SLO 후보이지 기본값이 아니다
변경 내용: OpenAI는 GPT-5.6 Sol용 Ultrafast를 제한 미리보기로 발표했고 최대 14배라는 상한을 제시했다. 실제 영향: 채팅 보조나 짧은 분류처럼 첫 토큰 지연에 민감한 경로의 실험 대상이 될 수 있다. 적용/회피 조건: 미리보기 접근 여부, 가격, 지원 리전, rate limit를 계약·프로젝트 단위로 확인하고 fallback 모델과 timeout을 둔다. 배포 파이프라인 수정이나 고객 데이터 변환처럼 정확성이 우선인 경로는 속도 계층만으로 승격하지 않는다. 검증 방법: feature flag 아래에서 5% 트래픽부터 시작해 TTFT, 전체 완료 시간, 429/5xx, 재시도, 사용자 취소, 답변 정확도 평가를 동시 비교한다.
3. 변하는 별칭과 고정 모델을 분리해야 회귀를 재현할 수 있다
변경 내용: chat-latest는 ChatGPT 최신 모델을 따라 정기적으로 업데이트되고, OpenAI는 생산 API에 GPT-5.6 Sol을 권고한다. 실제 영향: 별칭을 CI 생성, 코드 변환, 고객 답변에 쓰면 어제 통과한 프롬프트가 오늘 다른 출력·비용·안전 거동을 보일 수 있다. 적용/회피 조건: 실험 환경만 별칭을 사용하고 운영에는 명시 모델 ID를 configuration으로 둔다. model 변경은 prompt·tool schema·eval fixture 버전을 함께 올리는 change request로 취급한다. 검증 방법: 응답의 모델 식별자, 설정 hash, 평가 데이터 버전, 결과 score를 남기고 canary에서 기준선보다 정확도 2%p 하락 또는 비용 20% 초과 시 자동 rollback한다.
4. 데이터 보존과 도구 권한은 서비스 등급보다 먼저 점검한다
변경 내용: Responses API의 application state, background mode, MCP와 hosted container는 각각 다른 저장·제3자 데이터 경로를 가진다. 실제 영향: “API 데이터는 학습에 쓰이지 않는다”는 사실만으로 전송 가능 범위를 판단할 수 없다. 적용/회피 조건: 민감한 운영 지원은 store:false 여부와 조직의 ZDR/MAM 승인 상태를 보안 담당자와 확인한다. 원격 MCP에는 읽기 전용 검색과 쓰기 가능한 배포 권한을 분리하고, 서버가 아닌 브라우저에 API 키를 두지 않는다. 검증 방법: 요청별 데이터 분류 태그, tool host allowlist, 삭제 절차, 접근 로그를 감사한다. 프롬프트 인젝션 fixture가 외부 URL 호출·비밀 파일 읽기를 유도해도 거절되는지 격리 환경에서 시험한다.
개발자 실행 계획
- P0:
config/ai-routing.ts에 운영 모델, fallback, timeout, service tier를 명시하고 별칭 사용을 dev 전용으로 제한한다. - P0:
docs/ai-data-map.md에 Responses, background, MCP, container별 입력 데이터와 보존·삭제 책임자를 기록한다. - P1:
tests/ai-evals/에 Nuxt SSR 오류, route 변경, 보안 헤더, 의존성 업데이트 등 최소 10개 fixture를 만든다. - P1: OpenTelemetry 또는 요청 로그에 모델, tier, TTFT, 총 지연, 토큰, tool count, 오류 코드를 남기되 프롬프트 원문과 비밀은 마스킹한다.
- P1: Fast/Standard A/B를 비동기 코드 조사 작업부터 수행하고 CI 통과율·리뷰 수정량을 함께 판정한다.
- P2: preview 기능은 feature flag, rate-limit fallback, 월별 예산 alarm, 자동 중단 조건을 연결한다.
- P2: 분기마다 MCP host allowlist와 API 키 권한을 재검토하고 노출 의심 키는 즉시 폐기·교체한다.
리스크와 한계
Ultrafast는 제한 미리보기이므로 접근성과 장기 가격을 확정 사실처럼 설계하면 안 된다. Fast mode의 최대 배수도 Nuxt 코드베이스의 도구 호출·출력 길이·네트워크에 따라 달라진다. 롤백 조건은 p95가 기준선보다 악화, 평가 정확도 하락, 429 증가, 월 예산 초과, 의도하지 않은 tool host 접근이다. 이 경우 flag를 Standard/fallback으로 되돌리고 해당 trace·권한 정책·입력 필터를 조사한다. 데이터 제어의 적격성은 계약과 프로젝트 설정에 따르므로 보안·법무 승인 없이 민감 데이터를 전송하지 않는다.
FAQ
GPT-5.6 Fast mode를 Nuxt 에이전트에 바로 기본 적용해도 되나?
아니다. 장문 컨텍스트 지원은 유용하지만 실제 작업의 정확도, p95, 비용, CI 통과율을 Standard와 비교한 뒤 제한적으로 확대해야 한다.
chat-latest를 프로덕션에 쓰면 어떤 문제가 있나?
공식 문서처럼 이 별칭은 정기적으로 변경된다. 재현성·회귀 분석이 필요한 코드 생성과 고객 기능에는 명시된 모델 ID와 canary 절차가 더 적합하다.
store:false면 모든 데이터 보존 문제가 해결되는가?
아니다. endpoint, abuse monitoring, background mode, 파일·MCP 같은 기능별 규칙이 다르다. 해당 프로젝트의 ZDR/MAM 자격과 제3자 도구 보존 정책까지 확인해야 한다.
출처 및 추가 읽기
- OpenAI API Changelog — 2026년 8월 Fast mode·Ultrafast·chat-latest
- OpenAI Release Notes — Ultrafast mode for GPT-5.6 Sol
- OpenAI Docs — Fast mode
- OpenAI Docs — Data controls and retention
- OpenAI Docs — Safety best practices
- OpenAI Docs — Remote MCP tool
더 깊게 읽기: 실전 가이드
이 리포트는 최근 흐름을 빠르게 파악하기 위한 요약입니다. 실제 프로젝트에 적용할 때는 아래의 기준 글과 함께 확인하면 더 안전합니다.