

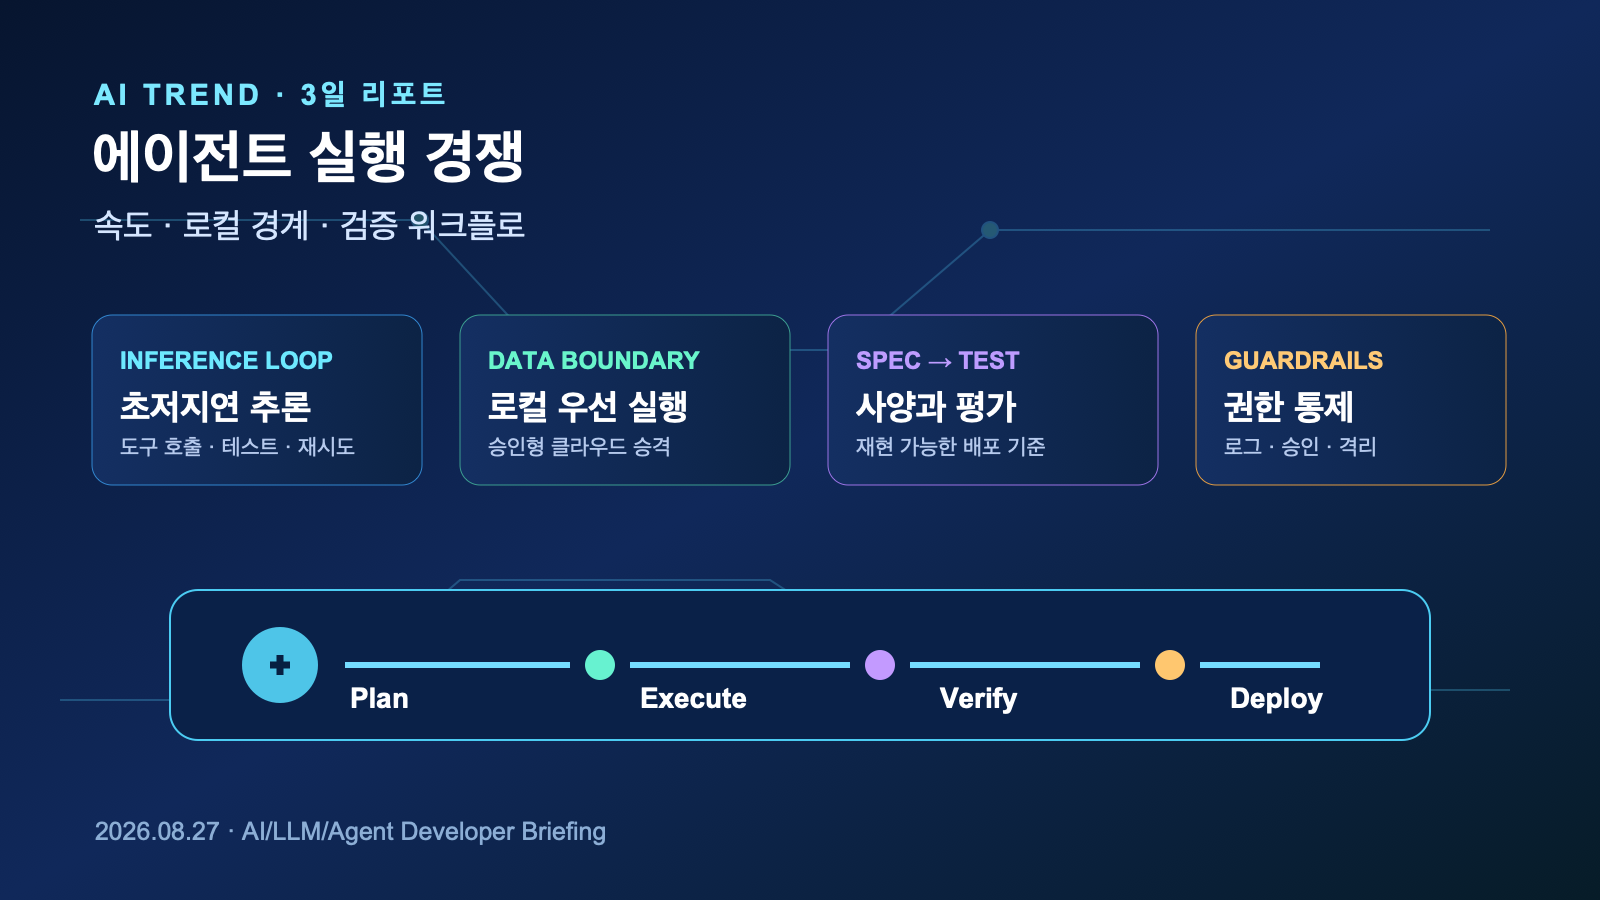
요약: 최근 72시간의 AI/LLM·AI Agent 흐름은 ‘더 큰 모델’보다 에이전트의 실행 단가·지연시간·데이터 경계·검증을 함께 설계하는 경쟁으로 이동했다. 로컬 우선 실행, 초저지연 추론, 사양 기반 개발, 생산 환경 평가가 한 묶음으로 중요해지고 있다.
핵심 답변: 지금 개발팀이 바꿔야 할 것은?
에이전트 도입의 병목은 모델 선택 하나가 아니다. 최근 발표들은 에이전트가 여러 번의 추론·도구 호출·검증을 반복할수록 토큰 생성 지연, 전력/비용, 민감 데이터 이동, 재현 가능한 평가가 제품 품질을 좌우한다는 점을 보여준다. 이번 3일 동안 확인된 실무 결론은 명확하다. 로컬 또는 격리 실행을 기본값으로 두고, 클라우드 고성능 모델은 승인된 단계에만 승격하며, PR·테스트·로그 기준으로 평가를 자동화해야 한다.
3일 결론
- 사실: OpenAI는 8월 25일 자체 추론 칩 Jalapeño의 전력당 처리량·지연시간 측정치를 공개했고, NVIDIA는 8월 24일 에이전트용 초저지연 추론 가속기 Groq 3 LPX의 양산을 발표했다. 두 발표 모두 에이전트의 다단계 루프에서 지연시간이 누적된다는 문제를 전면에 둔다.
- 사실: Perplexity는 8월 25일 로컬 장비에서 오케스트레이터·도구 라우터·작업 큐까지 실행하고 필요한 단계만 사용자 승인 아래 클라우드로 넘기는 Portable Computer를 공개했다.
- 해석: 모델 벤치마크 단독 비교보다 ‘작업당 성공률 × 검증 비용 × 데이터 이동량 × 응답 지연’을 함께 측정하는 운영 지표가 더 유용해지고 있다.
흐름 1. 에이전트 성능의 단위가 모델에서 ‘실행 루프’로 이동
초저지연 토큰 생성은 곧 도구 사용 여유다
NVIDIA는 Groq 3 LPX가 10만 토큰 문맥의 Gemma 4 31B에서 초당 3,400 출력 토큰을 기록했다고 발표했다. 회사 발표 기준으로 이는 에이전트 코딩과 같은 지연 민감 작업을 겨냥하며, 빠른 생성은 파일 검사·테스트·도구 호출·재시도에 쓸 수 있는 시간을 늘린다. NVIDIA 발표 원문
OpenAI도 Jalapeño에서 공개 모델 3종을 비교해 피크 처리량당 전력 효율 1.5~1.9배, 종단 지연 1.7~3.6배 개선을 보고했다. 이는 공급사 자체 측정이므로 일반화하기보다, 팀의 실제 도구 호출 비율과 문맥 길이에서 재현해 확인해야 한다. 다만 프리필·디코드·네트워크를 함께 설계해야 한다는 문제 정의는 에이전트 서비스의 비용 모델과 직접 연결된다. OpenAI Jalapeño 측정과 방법
실무 시사점: ‘초당 토큰’만 대시보드에 두지 말고, 작업별 첫 도구 호출 시간, 테스트 완료 시간, 재시도 횟수, 성공한 변경 1건당 비용을 함께 기록한다. 특히 병렬 서브에이전트는 평균 지연보다 가장 느린 작업과 검증 대기 시간이 사용자 체감 시간을 결정한다.
흐름 2. 로컬 우선·승인형 클라우드 승격이 데이터 경계의 기본 패턴으로 부상
민감 코드와 문서는 장비 안에서, 필요한 추론만 외부로
Perplexity의 Portable Computer는 DGX Spark에서 로컬 모델, 오케스트레이터, 플래너, 도구 라우터, 스케줄러, 작업 큐, 검색 인덱스를 실행한다고 밝혔다. 외부 웹·고급 추론이 필요한 경우에는 15개 이상 클라우드 모델로 승격할 수 있지만, 장치 밖으로 내용을 보내기 전 사용자 권한을 요청한다. 코드와 도구 실행은 통제된 접근의 격리 샌드박스에서 동작한다고 설명한다. Perplexity 공식 발표
실무 시사점: 이를 특정 제품의 도입 신호로만 볼 필요는 없다. 사내 에이전트에도 ① 로컬/사내 VPC에서 파일 인덱싱·정형 추출·테스트 실행, ② 외부 모델로 보내는 문맥의 최소화·마스킹, ③ 단계별 사용자 승인과 감사 로그라는 경계를 설계할 수 있다. ‘클라우드를 쓰지 않는다’가 아니라 ‘어떤 데이터와 권한이 어느 단계에서 이동하는가’를 정책으로 만드는 것이 핵심이다.
흐름 3. 사양·평가·검증이 에이전트 개발의 제품 기능이 된다
프롬프트 품질을 반복 가능한 입력과 평가로 바꾸기
Kiro는 요구사항·설계·순차 작업으로 프롬프트를 구조화하고, 병렬 에이전트와 속성 기반 테스트로 구현을 검증하는 사양 기반 개발 흐름을 제시한다. 에이전트가 코드를 작성한 뒤 ‘테스트 통과’만 확인하지 않고 요구사항 모순과 입력 공간의 경계 사례를 점검한다는 점이 중요하다. Kiro의 spec-driven 개발 설명
GitHub도 8월 25일 생산 배포 전 LLM 평가에서 깨끗한 벤치마크만으로는 부족하며, 실제 실패 사례에 가까운 오프라인 평가·재현 가능한 베이스라인·오류 분석을 정기 개발 흐름에 넣어야 한다고 권고했다. GitHub의 LLM 생산 평가 가이드
실무 시사점: AGENTS.md·SKILL.md·PR 템플릿을 에이전트의 ‘사양 인터페이스’로 취급하고, 성공 조건을 테스트·린트·시각 회귀·보안 검사로 명시한다. 모델을 교체해도 동일한 평가 세트를 통과해야 배포 후보가 되도록 만들면, 공급사 벤치마크의 변동성을 팀의 재현 가능한 근거로 바꿀 수 있다.
흐름 4. 빠른 모델은 더 넓은 권한이 아니라 더 촘촘한 통제를 요구
Google의 Gemini 3.7 Flash 발표은 코딩·웹 개발·업무 자동화에서의 성능 및 가격 개선을 강조하면서도 CBRN·사이버 오용에 대한 업데이트된 보호장치 적용을 함께 명시했다. Google Gemini 3.7 Flash 발표 이는 새 모델 발표일이 72시간 창보다 앞서지만, 이번 주 인프라 발표과 결합해 ‘더 빠른 에이전트에는 더 좁은 실행 권한과 관측성’이 필요하다는 지속 흐름을 뒷받침하는 현재 기준점이다.
전망(확정 사실 아님): 향후 개발자 도구 차별화는 단일 모델의 코드 생성 능력보다 권한 위임, 문맥 격리, 승인 UX, 작업 재생, 실패 복구를 얼마나 기본 기능으로 제공하는가에 더 크게 좌우될 가능성이 높다.
개발자 액션 체크리스트
- 이번 주: 하나의 반복 작업을 골라 ‘요구사항 → 변경 → 테스트 → 리뷰’의 성공 기준을 Markdown과 CI 명령으로 명시한다.
- 이번 주: 에이전트가 외부로 전송하는 파일·프롬프트를 목록화하고, 비밀값·개인정보 마스킹 및 사람 승인 지점을 만든다.
- 2주 내: 모델/도구별로 성공률, 재시도, 첫 도구 호출 시간, 테스트 통과 시간, 작업당 비용을 같은 로그 스키마로 수집한다.
- 배포 전: 대표 성공 사례뿐 아니라 실패한 이슈, 모호한 요구사항, 권한 거부, 네트워크 오류를 포함한 회귀 평가 세트를 실행한다.
자주 묻는 질문(FAQ)
Q. 로컬 실행이면 클라우드 모델이 필요 없나?
A. 아니다. 최근 로컬 우선 제품도 최신 웹 정보나 높은 추론 난도가 필요한 단계에서는 클라우드 승격을 사용한다. 핵심은 기본 경로와 승인·문맥 최소화·감사 가능성을 먼저 설계하는 것이다.
Q. 공급사 성능 수치를 바로 용량 계획에 써도 되나?
A. 아니다. 발표 수치는 특정 모델·문맥·하드웨어·측정 방법의 결과다. 팀의 실제 저장소 크기, 도구 호출 수, 동시성, 테스트 시간으로 작은 재현 실험을 먼저 해야 한다.
Q. 가장 먼저 자동화할 작업은 무엇인가?
A. 명확한 입력과 검증 가능한 출력이 있는 작업부터다. 예를 들어 린트 수정 제안, 테스트 실패 분류, 문서-코드 불일치 탐지처럼 권한 범위가 작고 CI로 결과를 판정할 수 있는 흐름이 적합하다.
출처와 확인 범위
본 리포트의 최근 72시간 핵심 사실은 8월 24~25일의 NVIDIA·OpenAI·Perplexity·GitHub 공식 발표을 우선 확인했다. Google Gemini 항목은 같은 운영·보호장치 흐름의 배경 자료이며 8월 13일 발표임을 본문에 명시했다. 공급사 성능 수치와 계획은 각 발표 주체의 측정·전망임을 구분해 해석했다.
더 깊게 읽기: 실전 가이드
이 리포트는 최근 흐름을 빠르게 파악하기 위한 요약입니다. 실제 프로젝트에 적용할 때는 아래의 기준 글과 함께 확인하면 더 안전합니다.