

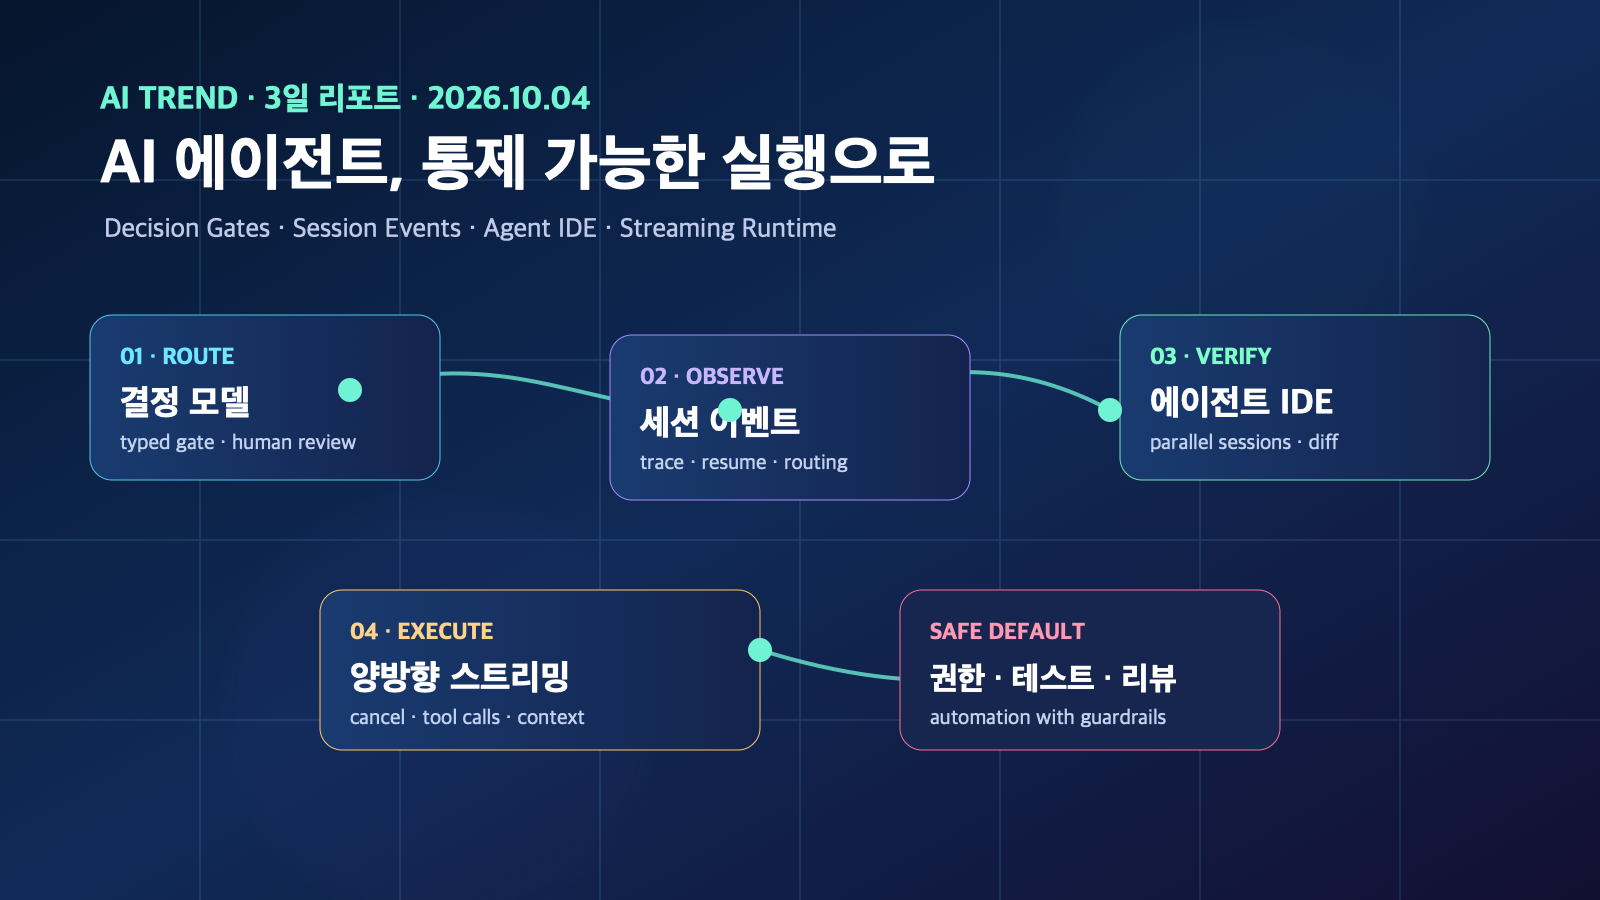
요약: 2026년 10월 1~4일의 AI/LLM·AI 에이전트 개발 도구 흐름은 ‘더 큰 모델’보다 통제 가능한 실행으로 무게가 이동했다. 구조화된 의사결정 모델, 세션 이벤트, 플러그인형 런타임, IDE 안의 병렬 에이전트 검증이 함께 등장하면서 실무의 핵심은 생성 품질만이 아니라 라우팅·권한·관측·리뷰를 한 흐름으로 묶는 일이다.
핵심 답변: 이번 3일의 변화는 무엇인가?
확인된 릴리스와 공식 발표를 묶으면, 에이전트 스택이 생성 모델 → 결정 계층 → 실행 런타임 → 개발자 검증 화면으로 분화되는 흐름이 뚜렷하다. Cloudflare는 정해진 스키마의 확률 답을 내는 결정 모델을, OpenAI SDK는 에이전트 세션 이벤트를, JetBrains는 병렬 에이전트 세션을 검토하는 IDE 경험을 각각 전면에 놓았다. 이는 단일 챗봇을 잘 프롬프트하는 방식보다 업무 단계마다 비용·위험·승인 기준을 다르게 설계하는 방식이 실용적이라는 신호다.
3일 결론
- 사실: 구조화된 판단, 세션 스트림, 양방향 도구 실행, 병렬 작업 화면이 실제 제품·SDK 릴리스에 포함됐다.
- 해석: 프로덕션 에이전트의 차별점은 모델 하나보다 ‘어떤 일을 자동화하고 어디서 멈추게 할지’를 결정하는 제어면(control plane)으로 이동한다.
- 실무 우선순위: 자유 텍스트 생성에 바로 권한을 주지 말고, typed gate·이벤트 trace·테스트/리뷰 게이트를 먼저 넣어야 한다.
흐름 1. LLM 앞단에 ‘결정 모델’이 들어온다
Cloudflare Clef/Clef-flash: 분류·라우팅을 별도 계층으로
Cloudflare의 10월 1일 발표에 따르면 Clef와 Clef-flash는 정해진 선택지에 대해 타입이 있는 확률 출력을 내는 오픈소스 결정 모델이며, Workers AI에서 제공되고 RL 미세조정도 지원한다. 일반 LLM의 자유 생성과 달리 ‘긴급한가’, ‘어느 팀으로 보낼까’, ‘사람 승인이 필요한가’ 같은 제한된 판단에 맞춘 설계다.
시사점: 에이전트가 도구를 호출하기 전, 저지연 결정 계층을 두면 비용이 큰 모델 호출과 위험한 실행을 모두 줄일 수 있다. 다만 확률값이 정답 보증은 아니다. 배포 전에는 임계값, 오판 비용, 거절·에스컬레이션 규칙을 업무별 평가셋으로 검증해야 한다.
흐름 2. 에이전트 SDK는 ‘요청-응답’에서 세션·이벤트로 이동한다
OpenAI Python SDK 3.24.0의 session events
OpenAI Python SDK v3.24.0 릴리스(10월 2일)는 custom voice creation과 agent session events를 추가하고, 요청 라우팅 필드와 parse helper의 우선순위 문제를 수정했다. 직전 v3.23.0에서도 typed session stream 답변, 파일 stage/download, session trace가 추가됐다.
시사점: 장기 실행 에이전트는 최종 텍스트만 저장해서는 디버깅할 수 없다. 세션 식별자, 이벤트 순서, tool input/output, 재시도, 라우팅 정보, 사람 개입을 같은 관측 단위로 보존해야 재개와 사후감사가 가능하다. ‘세션 이벤트가 있으니 자동으로 안전하다’는 결론은 성립하지 않으며, 내구성·보존 기간·개인정보 경계는 서비스별 문서와 계약을 별도로 확인해야 한다.
흐름 3. 코딩 에이전트의 경쟁점은 플러그인과 병렬 검증이다
Claude Code Mods와 JetBrains Air EAP
Anthropic은 10월 1일 Claude Code Mods를 발표해 런타임 이벤트에 개입하는 확장 지점을 제시했다. 같은 기간 JetBrains Air EAP는 Codex·GitHub Copilot·Junie·Cursor 및 ACP 호환 에이전트를 IDE로 가져와 다중 세션, 변경 파일, 비용, 커밋을 한곳에서 확인하는 경험을 공개했다.
시사점: 에이전트가 코드를 만드는 속도보다, 여러 에이전트의 변경을 격리하고 사람이 차이를 검토하며 테스트 결과로 병합하는 흐름이 중요해진다. 특히 런타임 확장은 프롬프트·도구 호출·권한에 영향을 줄 수 있으므로 플러그인은 패키지 의존성처럼 출처, 권한, 버전 고정, 제거 절차를 관리해야 한다.
흐름 4. 대화형 실행은 취소·도구 결과·문맥 관리가 제품 기능이 된다
Strands Harness SDK 1.57.2
Strands Harness Python v1.57.2(10월 1일)는 양방향 스트리밍 API의 정식화, custom tool의 취소 지원, 콘솔에서의 도구 호출 표시, 그룹화된 tool call 보존, 텍스트·reasoning stream event 등을 포함했다. 세션 재개 뒤 도구 결과를 전달하는 수정도 함께 들어갔다.
시사점: 음성·채팅·도구 실행이 섞인 에이전트는 ‘완료 응답’만으로 충분하지 않다. 취소 신호가 실제 하위 작업까지 전파되는지, 재연결 뒤 중복 실행이 없는지, 큰 도구 결과를 어떤 정책으로 보관·압축하는지를 장애 시나리오에서 시험해야 한다.
개발자 액션 체크리스트
- 이번 주: 에이전트의 각 tool call 앞에 allow / deny / human-review 중 하나를 반환하는 typed decision gate를 한 개 업무에 시범 적용한다.
- 관측성: session ID, trace ID, 모델·도구 버전, 입력 요약, 결정 근거, 비용, diff, 테스트 결과를 한 실행 레코드로 연결한다.
- 병렬 개발: 에이전트마다 worktree 또는 독립 브랜치를 사용하고, 자동 테스트·정적 분석·사람 리뷰를 통과한 변경만 병합한다.
- 확장 보안: 플러그인/Mods는 신뢰 출처만 허용하고, 파일·쉘·비밀정보 접근 권한과 롤백 방법을 등록한다.
짧은 Q&A
Q. 지금 바로 결정 모델로 LLM을 대체해야 하나?
A. 아니다. 분류·라우팅·정책 판정처럼 출력 공간이 제한된 단계부터 분리하는 것이 적합하다. 복합 추론과 사용자 응답은 여전히 일반 LLM과 평가·사람 검토가 필요하다.
Q. 병렬 코딩 에이전트의 첫 안전장치는 무엇인가?
A. 격리된 작업 공간과 변경 검증이다. 동시에 실행하는 수를 늘리기 전에 브랜치/worktree 격리, 권한 최소화, 재현 가능한 테스트, 명확한 병합 책임자를 정한다.
주요 출처
- Cloudflare — Clef decision models and RL fine-tuning (2026-10-01)
- OpenAI — openai-python v3.24.0 release (2026-10-02)
- Anthropic — Customize Claude Code with mods (2026-10-01)
- JetBrains — Air in IDEs EAP (2026-10-01)
- Strands Agents — Harness Python v1.57.2 release (2026-10-01)
더 깊게 읽기: 실전 가이드
이 리포트는 최근 흐름을 빠르게 파악하기 위한 요약입니다. 실제 프로젝트에 적용할 때는 아래의 기준 글과 함께 확인하면 더 안전합니다.