

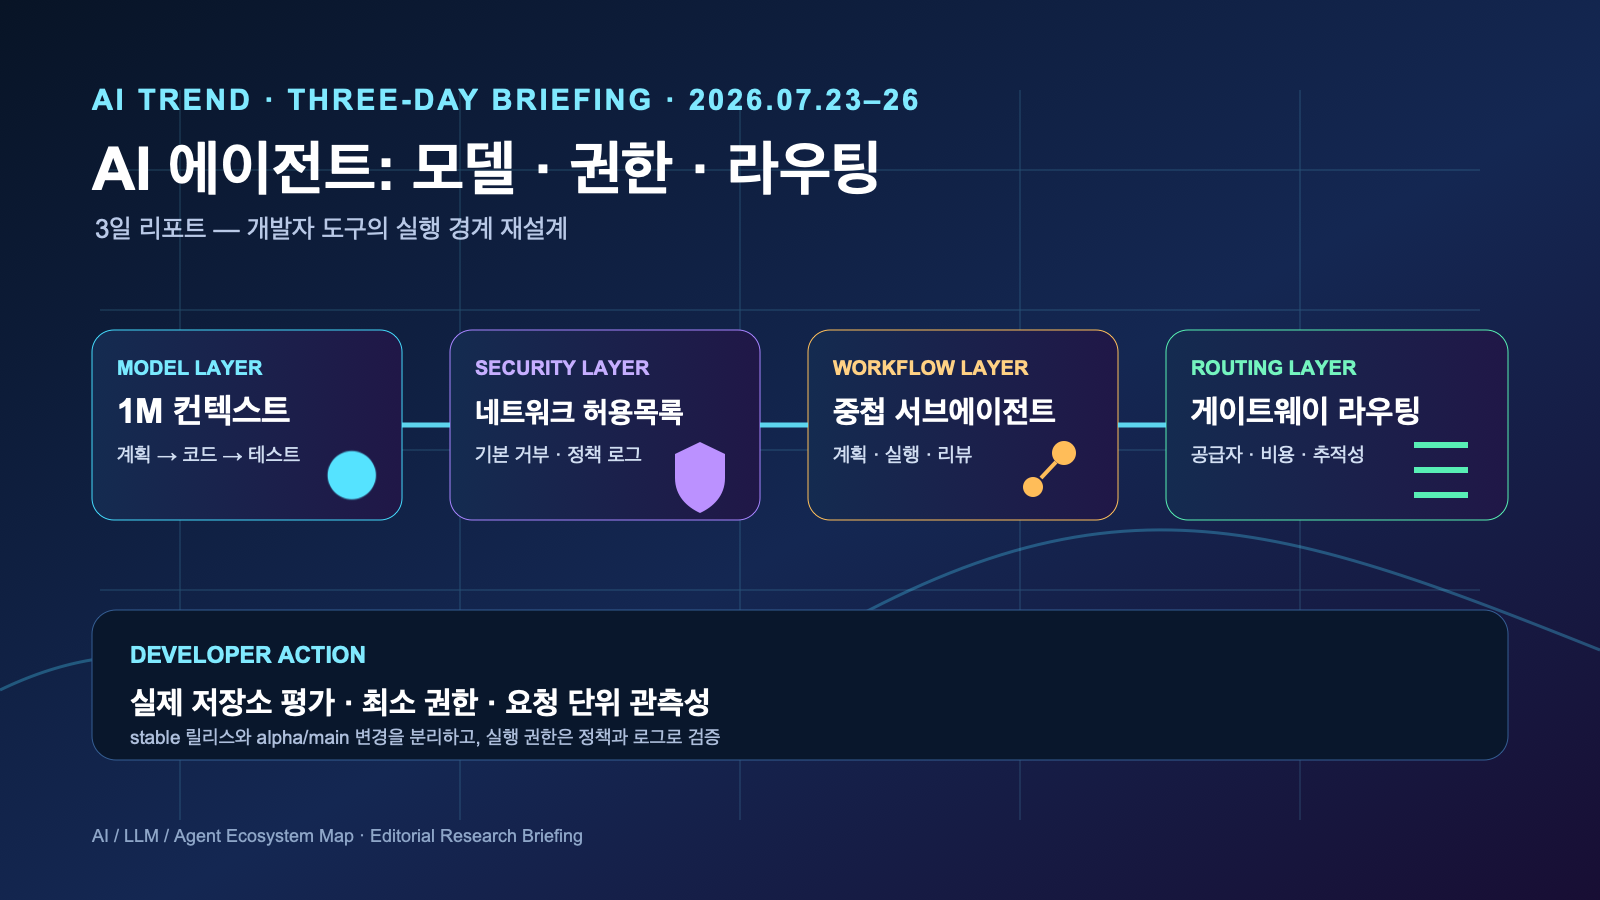
요약: 2026년 7월 23~26일(한국 시간)의 AI/LLM·AI Agent 개발자 도구 흐름은 긴 컨텍스트 모델을 실제 에이전트 워크플로에 연결하는 일, 네트워크·권한 경계를 제품 설정으로 고정하는 일, 그리고 모델 공급자와 게이트웨이를 분리해 운영하는 일으로 압축된다. 이번 3일 리포트는 AI 에이전트를 도입하는 개발팀이 성능 발표보다 먼저 점검할 실행 경계와 관측성의 기준을 정리한다.
핵심 답변: 지금 AI 에이전트 팀이 먼저 바꿔야 할 것은?
새 모델을 바로 전사 기본값으로 바꾸기보다, 작업 단위 평가·기본 거부 네트워크 정책·공급자 라우팅 로그를 함께 갖추는 것이 우선이다. Claude Code v2.1.219 공식 릴리스는 Opus 5를 기본 Opus 모델로 두고 1M 컨텍스트를 명시하는 동시에, 샌드박스 명령의 비허용 호스트를 프롬프트 없이 차단하는 sandbox.network.strictAllowlist를 추가했다. 이는 모델 성능과 실행 통제가 별도 선택지가 아니라 같은 개발자 경험의 일부가 되고 있음을 보여 준다.
- 확인된 사실: Claude Code v2.1.219에는 Opus 5 기본 모델, 네트워크 strict allowlist, 새 작업 디렉터리 등록 뒤의
DirectoryAdded훅, 헤드리스 초기화의 MCP 서버 오류 정보가 포함됐다. - 확인된 사실: langchain-anthropic 1.5.2는 Claude Opus 5 지원을, langchain-openai 1.4.1은 환경변수 기반 LangSmith Gateway 지원과
gpt-5.3-chat-latest프로필 수정을 릴리스 노트에 기록했다. - 해석: 에이전트의 품질 평가는 모델 점수 하나가 아니라 모델 선택, 도구 호출, 네트워크 목적지, 승인, 실패 로그가 연결된 운영 단위로 옮겨가고 있다.
3일 결론: 모델 확장과 실행 경계가 한 릴리스 단위가 됐다
이번 기간에는 “더 긴 컨텍스트”와 “더 많은 자율 실행”이 함께 등장했다. Claude Code의 릴리스는 최대 컨텍스트와 빠른 모드 같은 모델 선택 정보를 제시하면서, 동시에 샌드박스 네트워크 목적지를 엄격히 제한할 수 있게 했다. 또한 중첩 서브에이전트 전달과 MCP 연결 실패의 구조화된 노출은, 여러 에이전트를 쓰는 팀이 실행 그래프를 더 잘 관찰하도록 돕는다.
실무 시사점: 저장소를 탐색하고 테스트를 고치며 외부 문서를 읽는 코딩 에이전트는 단순 채팅 UI가 아니다. 파일·네트워크·MCP 서버·CI 자격증명에 닿는 실행 시스템이다. 따라서 새 모델의 문맥 길이나 속도만 비교하지 말고, 어떤 도구를 언제 호출했는지와 어떤 정책이 이를 허용했는지를 함께 남겨야 한다.
흐름 1. 긴 컨텍스트 모델은 멀티에이전트 작업 분해를 다시 설계하게 한다
사실 → 근거 → 시사점
사실: Claude Code v2.1.219는 Claude Opus 5를 기본 Opus 모델로 추가하고 1M 컨텍스트를 명시했으며, 서브에이전트가 기본적으로 깊이 3까지 중첩 서브에이전트를 생성할 수 있도록 변경했다. 근거: 이 범위와 설정은 공식 GitHub 릴리스 노트에 적혀 있다. 시사점: 큰 컨텍스트가 곧 더 좋은 자동화라는 뜻은 아니다. 팀은 상위 에이전트의 계획, 하위 에이전트의 좁은 실행 범위, 사람이 검토할 산출물을 명확히 나눠야 한다.
긴 컨텍스트는 설계 문서·이슈·테스트·코드를 한 번에 참조하는 데 유리하지만, 불필요한 문서와 외부 지시까지 작업 문맥으로 끌어들일 위험도 커진다. 특히 중첩 구조에서는 상위 작업이 하위 작업에 전달한 목표와 권한이 추적 가능해야 한다. 각 하위 작업마다 변경 허용 디렉터리, 실행 가능한 명령, 완료 조건, 사람에게 넘길 조건을 짧은 계약으로 남기는 편이 안전하다.
- 복잡한 리팩터링은 계획 에이전트와 구현 에이전트를 분리하고, 구현 에이전트에는 필요한 파일 범위만 준다.
- 중첩 에이전트의 결과는 설명·diff·테스트 결과를 묶어 상위 에이전트와 리뷰어에게 전달한다.
- 모델 변경 후에는 작업 성공률뿐 아니라 재시도 횟수, 수정 파일 수, 리뷰 리드타임을 같은 대표 과제로 비교한다.
흐름 2. 네트워크 허용목록과 MCP 오류 가시성이 에이전트 보안의 기본층이 된다
기본 거부가 중요한 이유
사실: Claude Code의 새 sandbox.network.strictAllowlist 설정은 샌드박스 명령이 허용목록에 없는 호스트로 연결하는 것을 프롬프트 없이 거부하도록 한다. 같은 릴리스는 설정 검증에서 제외된 --mcp-config 항목을 헤드리스 stream-json 초기 이벤트의 mcp_server_errors로 제공하고, 터미널에서는 시작 경고를 낸다. 근거: 릴리스 원문의 보안·MCP 변경 항목이다. 시사점: 에이전트 보안은 “승인 팝업을 많이 띄우는가”가 아니라, 기본적으로 어디에 연결할 수 없고 실패가 어디에서 발생했는지 운영자가 재현할 수 있는가의 문제다.
실행형 에이전트는 웹 검색, 패키지 설치, 문서 조회, 원격 MCP 도구를 통해 외부 입력을 계속 받는다. 따라서 외부 콘텐츠 안의 도구 지시나 예상하지 못한 의존성 다운로드가 비밀·소스·네트워크 경계로 이어지지 않도록 해야 한다. strict allowlist는 유용한 제어점이지만, 팀의 도메인·아티팩트 레지스트리·모니터링 목적지를 명시적으로 관리하지 않으면 개발 흐름을 불필요하게 막을 수도 있다.
이번 주 적용할 보안 체크리스트
- 네트워크: 에이전트 샌드박스는 기본 거부로 시작하고, 패키지 레지스트리·문서·내부 API를 목적별 허용목록으로 운영한다.
- 비밀: 개발용 환경변수, SSH 키, 배포 토큰은 에이전트 작업 프로세스에 기본 주입하지 않는다. 짧은 수명의 범위 제한 자격증명을 사용한다.
- MCP: 서버 이름만 기록하지 말고 연결 성공/실패, 제공 도구, 호출 시각, 실패 사유를 수집한다.
- 승인: 외부 네트워크·패키지 설치·브랜치 쓰기·배포는 서로 다른 승인 규칙과 감사 로그를 적용한다.
흐름 3. 모델 통합은 SDK 기능보다 라우팅·관측성 문제로 이동한다
사실: LangChain의 7월 24일 릴리스 langchain-anthropic 1.5.2는 Claude Opus 5 지원을 추가했다. 7월 23일 langchain-openai 1.4.1은 Anthropic·Fireworks·OpenAI 관련 LangSmith Gateway 환경변수 지원을 넣고 OpenAI 모델 프로필을 수정했다. 시사점: 여러 모델을 하나의 앱에 붙이는 비용은 호출 코드보다, 요청이 어느 공급자·정책·비용 한도를 통해 흘렀는지를 파악하는 비용에서 커진다.
게이트웨이 지원은 공급자 전환과 중앙 정책 적용에 도움이 될 수 있지만, 자동으로 복원력이나 비용 절감을 보장하지는 않는다. 라우팅 계층을 넣을 때는 모델 ID, 폴백 조건, 타임아웃, 최대 토큰, 도구 사용 여부, 사용자 영향도를 동일한 요청 ID로 묶어 기록해야 한다. 그래야 특정 모델의 실패인지, 게이트웨이 정책의 차단인지, MCP 도구의 오류인지 분리할 수 있다.
- 낮은 위험의 문서·테스트 설명 작업과 저장소 변경·배포 작업에 서로 다른 모델·권한 정책을 둔다.
- 라우팅 규칙은 코드와 설정으로 버전 관리하고, 모델 기본값 변경 시 대표 작업 회귀 테스트를 돌린다.
- 총 비용은 토큰 단가만이 아니라 재시도, 사람 리뷰, 실패 복구 시간을 포함해 계산한다.
흐름 4. 빠른 코딩 도구 업데이트는 안정 채널과 개발 채널을 분리해서 읽어야 한다
사실: OpenAI Codex는 7월 25일 0.146.0-alpha.10.1을 GitHub prerelease로 게시했다. 같은 기간의 main 커밋에는 실행 서버 네트워크 정책 요청 처리 작업이, 다른 main 커밋에는 허용목록이 없을 때의 플러그인 MCP 필터링 변경이 보인다. 주의: 이 커밋들은 main 브랜치의 개발 중 작업이며, 안정 릴리스 기능으로 간주할 수 없다.
실무 시사점: alpha·nightly·main의 보안 또는 UX 변경은 방향을 파악하는 데는 유용하지만, 프로덕션 배포 근거는 공식 안정 릴리스 노트와 재현 테스트여야 한다. 특히 네트워크 승인·MCP 필터링처럼 신뢰 경계에 닿는 항목은 버전 고정, 변경 로그 확인, 격리 환경 검증 후에만 채택하는 편이 맞다.
개발자 액션 플랜: 다음 스프린트에서 할 일
1일차 — 대표 작업으로 모델과 에이전트를 평가한다
최근 PR·장애·리팩터링에서 10개 안팎의 실제 작업을 고른다. 각 작업에 성공 조건, 금지된 파일·명령, 테스트 기준, 사람 승인 지점을 정의한다. 모델별로 수용 가능한 diff 비율, 테스트 통과율, 리뷰 시간, 비용, 재시도 사유를 기록하면 새 모델의 가치를 과장 없이 비교할 수 있다.
2일차 — 실행 경계를 정책으로 만든다
에이전트가 접근하는 디렉터리, 네트워크 목적지, MCP 서버, 환경변수, Git·배포 권한을 표로 만든다. 그다음 기본 거부 정책에서 필요한 항목만 추가한다. 위험한 변경은 임시 브랜치·임시 자격증명·격리 실행으로 제한하고, 승인 로그에는 실제 명령과 대상 경로를 남긴다.
3일차 — 라우팅과 관측성을 배포 정의에 넣는다
요청 ID 하나로 모델·게이트웨이·툴 호출·정책 판정·테스트·사람 승인을 연결한다. 장애가 나면 프롬프트나 모델만 바꾸기 전에 어느 경계에서 실패했는지 분류한다. 이 데이터가 쌓여야 모델 업데이트를 안전하게 롤아웃하고, 비용 상한을 지키면서도 개발자 경험을 개선할 수 있다.
FAQ: AI 에이전트 도구를 어떻게 도입해야 하나?
Q. 1M 컨텍스트 모델이 나오면 기존 작업 흐름을 없애도 될까?
A. 아니다. 큰 문맥은 참고 자료를 넓힐 수 있지만, 작업 범위·검증·승인 책임을 대체하지 않는다. 오히려 더 많은 입력을 읽는 에이전트일수록 신뢰하지 않는 콘텐츠와 비밀 접근을 분리해야 한다.
Q. 네트워크 허용목록만 설정하면 에이전트 보안은 충분한가?
A. 아니다. 허용목록은 외부 연결의 한 층일 뿐이다. 파일 범위, 자격증명 수명, MCP 도구 신뢰도, 사람 승인, 변경 후 테스트와 롤백을 함께 설계해야 한다.
Q. 여러 공급자를 게이트웨이로 묶을 때 가장 먼저 볼 지표는?
A. 정답 정확도 하나보다 요청별 모델·도구·정책의 추적 가능성을 먼저 본다. 그 위에 작업 성공률, 총비용, p95 지연 시간, 재시도율, 사람 리뷰 시간을 올려 비교해야 한다.
출처와 편집 원칙
- Anthropic Claude Code v2.1.219 — 공식 릴리스 노트 (2026-07-24 UTC)
- Anthropic Claude Code v2.1.220 — 신뢰성 수정 릴리스 (2026-07-25 UTC)
- LangChain langchain-anthropic 1.5.2 — 공식 릴리스 노트 (2026-07-24 UTC)
- LangChain langchain-openai 1.4.1 — 공식 릴리스 노트 (2026-07-23 UTC)
- OpenAI Codex 0.146.0-alpha.10.1 — prerelease (2026-07-25 UTC)
편집 원칙: 사실 항목은 위의 공식 릴리스·정확한 커밋을 기준으로 확인했다. “시사점”과 “액션”은 그 사실에 근거한 운영 권고다. alpha 및 main 브랜치 항목은 배포 가능한 안정판으로 표현하지 않았으며, 실제 도입 전에는 각 공급자의 최신 릴리스 노트와 조직 보안 정책을 다시 확인해야 한다.
더 깊게 읽기: 실전 가이드
이 리포트는 최근 흐름을 빠르게 파악하기 위한 요약입니다. 실제 프로젝트에 적용할 때는 아래의 기준 글과 함께 확인하면 더 안전합니다.