

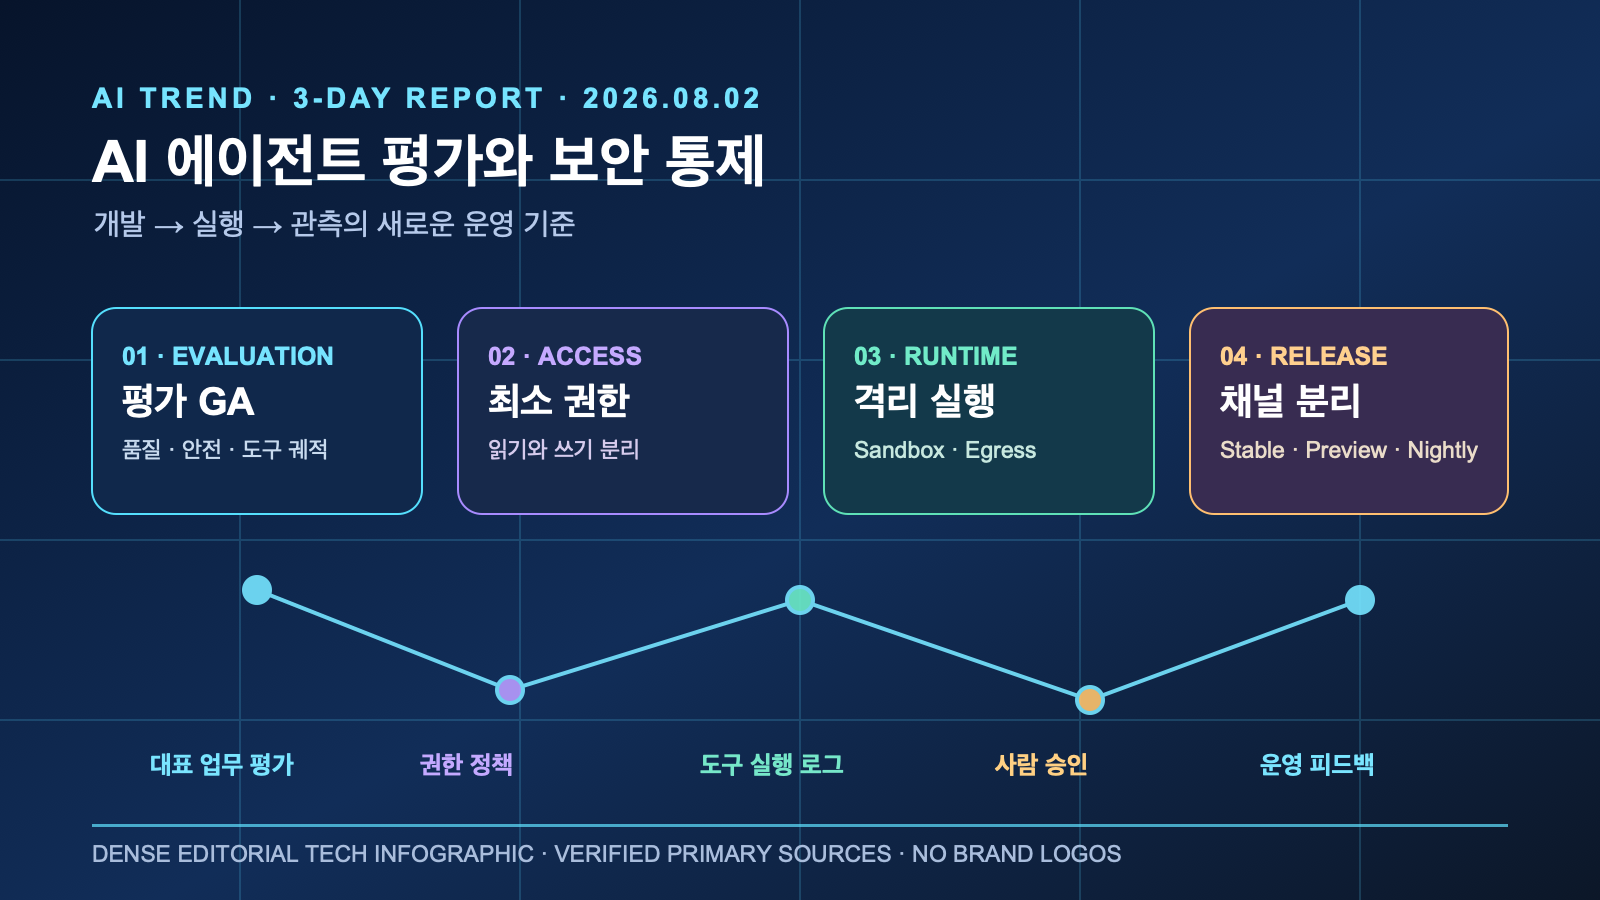
핵심 답변: 2026년 7월 30일~8월 2일의 AI/LLM·AI 에이전트 개발 흐름은 ‘더 자율적인 에이전트’를 도입하는 경쟁보다 동일한 평가 기준, 결정론적 권한 경계, 배포 뒤 관측을 먼저 갖추는 경쟁으로 이동했다. Google은 Gemini Enterprise Agent Platform의 에이전트·모델 평가를 정식 출시했고, NVIDIA와 AWS는 에이전트의 접근권한·샌드박스·네트워크·승인 통제를 각각 실무 프레임으로 제시했다. 같은 기간 Gemini CLI의 안정화 패치는 개발자 도구가 모델 성능뿐 아니라 실패·재시도 경험까지 제품 품질로 다뤄야 함을 보여준다.
요약: 이번 3일 리포트의 핵심은 AI 에이전트를 ‘코드를 빨리 만드는 도구’가 아니라, 평가 데이터·도구 권한·실행 격리·운영 로그가 연결된 소프트웨어 공급망으로 운영해야 한다는 점이다. 새 도구를 전사에 열기보다 대표 업무로 평가하고, 읽기와 쓰기 권한을 분리하며, 배포 이후의 실제 작업 궤적을 점검하는 순서가 안전하다.
3일 결론: 확인된 발표는 평가 기능의 GA와 보안 통제 권고다. “특정 제품이 모든 팀에 더 안전하거나 생산적이다”는 결론은 아직 확인되지 않았다. 따라서 실무 적용은 모델 벤치마크가 아니라 실제 저장소의 실패율·테스트 통과·권한 위반·작업당 비용을 함께 비교하는 제한적 파일럿에서 시작해야 한다.
72시간에 반복된 핵심 흐름
1. 에이전트 평가는 개발 단계와 운영 단계를 하나의 기준으로 묶는다
확인된 사실: Google은 7월 31일 Gemini Enterprise Agent Platform의 Agent and Model Evaluations가 정식 출시(GA)됐다고 발표했다. 사전 구축된 20개 이상 지표는 품질·안전·grounding·도구 사용·trajectory·참조 기반 점수를 포괄하며, 코드 기반 또는 LLM-as-a-judge 지표를 조직 단위로 버전 관리할 수 있다. 서버 측 실험은 Cloud Storage에 산출물을 보관하고, 실제 운영 트래픽을 평가 데이터로 다시 활용하는 구조도 제공한다.
시사점: 에이전트 평가는 “정답을 맞혔는가” 한 줄로 끝나지 않는다. 예를 들어 Nuxt의 서버 라우트 수정은 빌드 성공 외에 호출한 도구, 바꾼 파일 범위, 민감 경로 접근, 테스트 실패 후 재시도, 사람의 되돌림까지 함께 봐야 한다. 개발용 프롬프트 세트와 운영 로그를 서로 다른 채점기로 보면 드리프트 원인을 구분하기 어렵다. Google의 발표는 이를 같은 평가 엔진과 일관된 지표로 다루는 방향을 명시한다.
실무 해석: GA는 해당 기능을 도입할 수 있다는 뜻이지, 어떤 모델·업무 조합이 자동으로 적합하다는 보증은 아니다. LLM 심사 지표에는 모델 호출 비용이 발생할 수 있으므로, 조직은 정성 평가와 결정론적 검사(테스트·정책·스키마)를 혼동하지 말아야 한다.
2. 보안의 중심은 프롬프트 필터가 아니라 권한·격리·네트워크 경계다
확인된 사실: NVIDIA AI Red Team은 7월 30일 엔터프라이즈 AI 에이전트에서 반복적으로 관찰한 실패 모드로 부실한 접근 제어, 에이전트 도구를 통한 임의 코드 실행, 네트워크 egress 통제 부재, 평문 비밀의 실행 환경 노출을 제시했다. 권고는 강한 접근 제어, 샌드박스 실행, 기본 거부(default-deny) 네트워크와 최소 허용목록, 지속형 비밀을 에이전트 환경에서 제외하는 것이다.
확인된 사실: AWS Security Blog도 7월 30일 AI 코딩 에이전트 통제 프레임을 통해 외부 문서·이슈·패키지 텍스트가 간접 프롬프트 인젝션으로 에이전트를 유도할 수 있다고 설명한다. AWS는 비신뢰 입력을 읽는 에이전트와 신뢰된 행동을 오케스트레이션하는 에이전트를 분리하고, 노출된 에이전트에는 읽기 전용·최소 권한을 주며 비가역 행동에는 사람 승인을 요구하라고 권고한다.
시사점: 두 1차 출처가 독립적으로 같은 결론을 강조한다. 모델에게 “안전하게 행동하라”고 지시하거나, 사후 LLM 심사 하나를 두는 것만으로는 실행 경계를 만들 수 없다. 특히 npm install, 테스트 실행, 브라우저 자동화, 이슈·문서 탐색이 이어진 코딩 에이전트는 외부 텍스트와 파일·명령·네트워크 권한을 동시에 갖기 쉽다. 따라서 도구 호출의 허용 여부는 모델 출력 밖에서 정책으로 판정해야 한다.
3. 개발자 CLI는 화려한 기능보다 실패 처리와 릴리스 채널 구분이 중요하다
확인된 사실: Google의 Gemini CLI v0.53.1은 7월 31일 공개됐다. 릴리스 노트는 특정 빈 스트림 오류의 안내를 UI에 전달하는 변경과, 용량 소진을 재시도 대기로 남기지 않고 종료 상태로 분류하는 수정을 담고 있다. 같은 시점의 v0.54.0-preview.1과 nightly 채널은 별도의 사전 릴리스다.
시사점: 이 변경은 대형 기능 출시가 아니라 안정성 패치다. 그러나 에이전트가 CI나 긴 작업을 수행할 때 재시도 대기와 모호한 실패 메시지는 비용·대기시간·사람 개입을 키운다. 팀은 stable, preview, nightly를 같은 승인 수준으로 다루지 말고, 생산 자동화에는 고정된 stable 버전과 명시적 타임아웃·재시도 상한을 사용해야 한다. preview/nightly는 격리된 평가 환경에서만 검증하는 것이 적절하다.
4. 경량 SDK 업데이트도 인증·게이트웨이 경로는 회귀 시험 대상이다
확인된 사실: langchain-core 1.5.3은 7월 30일 공개됐으며, release body에는 gateway 설정에서 LANGSMITH_API_KEY로 대체(fallback)하는 수정이 기록돼 있다. 이는 새 에이전트 기능 발표가 아니라 구성 경로를 고치는 패치다.
시사점: 환경변수·게이트웨이·관측성 SDK의 작은 변경도 실제 배포에서는 권한과 데이터 경로를 바꿀 수 있다. 릴리스 노트만 보고 무조건 올리기보다, 스테이징에서 키가 없는 경우·명시 키가 있는 경우·프록시 경유·로그 마스킹을 각각 시험해 의도하지 않은 인증 fallback이나 텔레메트리 누락이 없는지 확인해야 한다.
개발자 실행 체크리스트: 이번 주에 할 일
- P0 — 대표 업무 8~12개를 고정한다. 버그 수정, 테스트 작성, 문서 검색, 의존성 갱신, 서버 라우트 변경처럼 자주 일어나는 작업을 선정하고, 성공 조건을 테스트 통과뿐 아니라 수정 파일 수·사람 리뷰 시간·되돌림·도구 호출로 기록한다.
- P0 — 권한 그래프를 분리한다. 문서·이슈·웹 검색을 읽는 에이전트에는 기본 읽기 전용 권한을 주고, 커밋·PR·배포·비밀 접근은 별도 실행자와 명시적 승인으로 나눈다. production 자격증명은 에이전트 컨테이너에 지속적으로 넣지 않는다.
- P0 — egress와 실행을 기본 거부로 시작한다. 허용한 도메인, 패키지 레지스트리, 명령, 작업 디렉터리만 열고 나머지는 차단한다. 임시 샌드박스와 작업별 짧은 수명의 토큰을 사용한다.
- P1 — 평가·운영 로그의 지표 이름을 통일한다. 정적 테스트, 정책 위반, grounding, 도구 성공/실패, 작업 궤적, 비용을 같은 업무 ID에 연결한다. 프롬프트 원문과 비밀값이 로그에 남지 않도록 마스킹·보존 기간·열람 역할을 먼저 정한다.
- P1 — 릴리스 채널 정책을 문서화한다. stable은 검증된 버전 고정, preview는 테스트 조직, nightly는 재현 가능한 실험으로 구분한다. 자동 업데이트를 켜기 전에 롤백 버전과 재시도 상한을 명시한다.
적용 순서: 속도와 통제를 같이 얻는 방법
첫째, 작은 저장소 또는 격리된 브랜치에서 에이전트에게 읽기·검색·테스트만 허용한다. 둘째, 동일한 태스크 세트로 두 모델 또는 두 도구 버전을 비교한다. 셋째, 사람이 확인해야 하는 변경(의존성 추가, 외부 네트워크, 배포 설정, 권한 파일 수정)을 정책 엔진에서 멈춘다. 넷째, 병합 후에는 운영 실패와 비용을 사전 평가 결과에 다시 연결한다. 이 순서는 생산성을 늦추기 위한 절차가 아니라, 어떤 자동화가 실제로 시간을 줄이는지 측정하기 위한 최소한의 실험 설계다.
특히 프론트엔드·서버 경계가 함께 있는 프로젝트에서는 에이전트의 결과물을 하나의 diff로만 보지 않는다. nuxt.config, server API route, 환경 변수, CI, 패키지 잠금 파일에 닿는 작업은 위험 등급을 높이고, 테스트 격리·네트워크 allowlist·승인을 동시에 요구하는 편이 안전하다. 반대로 문서 초안, 로컬 타입 오류, 테스트 fixture 생성처럼 되돌릴 수 있는 작업은 낮은 권한에서 빠르게 실험할 수 있다.
FAQ
AI 에이전트 평가 도구를 도입하면 사람 리뷰를 줄여도 되나?
아니다. 평가 도구는 반복 가능한 품질·안전·도구 사용 신호를 만들지만, 비가역 배포·권한 확대·고객 데이터 처리의 판단을 자동으로 대체하지 않는다. 먼저 어떤 위험에서 사람 승인이 필요한지 정하고, 평가는 그 판단을 더 일관되게 만드는 보조 수단으로 사용한다.
프롬프트 인젝션 방어를 위해 금지어 필터나 LLM 심사만 두면 충분한가?
충분하지 않다. NVIDIA와 AWS의 최근 권고는 접근 제어, 격리, egress 제한, 비밀 분리, 최소 권한 같은 결정론적 통제를 강조한다. 외부 텍스트를 읽는 에이전트가 쓰기 권한과 광범위한 네트워크 권한을 동시에 가지지 않도록 설계해야 한다.
Gemini CLI preview나 nightly를 생산 CI에 바로 써도 되나?
권장하지 않는다. v0.54.0-preview.1과 nightly는 사전 릴리스 채널이다. production에는 검증된 stable 버전을 잠그고, 사전 릴리스는 별도 평가 환경에서 오류 처리·비용·호환성을 확인한 뒤 채택 여부를 결정한다.
한계와 출처
이 리포트는 2026년 7월 30일~8월 2일 KST에 공개·확인된 1차 출처를 중심으로 작성했다. Google의 GA 발표과 GitHub 릴리스 노트는 제품의 제공 범위와 변경점을 설명하지만, 개별 팀의 품질·비용·보안 성과를 보장하지 않는다. NVIDIA와 AWS의 글은 각 기업의 기술·보안 권고이며, 여기서 제시한 적용 우선순위는 이를 바탕으로 한 편집상 해석이다.
- Google Developers Blog — Agent and Model Evaluations in Gemini Enterprise Agent Platform are now GA (2026-07-31)
- NVIDIA Technical Blog — Four Ways to Deploy More Secure AI Agents (2026-07-30)
- AWS Security Blog — A control framework for AI coding agents (2026-07-30)
- Gemini CLI GitHub Release — v0.53.1 (2026-07-31)
- Gemini CLI GitHub Release — v0.54.0-preview.1 (prerelease, 2026-07-31)
- LangChain GitHub Release — langchain-core 1.5.3 (2026-07-30)
더 깊게 읽기: 실전 가이드
이 리포트는 최근 흐름을 빠르게 파악하기 위한 요약입니다. 실제 프로젝트에 적용할 때는 아래의 기준 글과 함께 확인하면 더 안전합니다.