

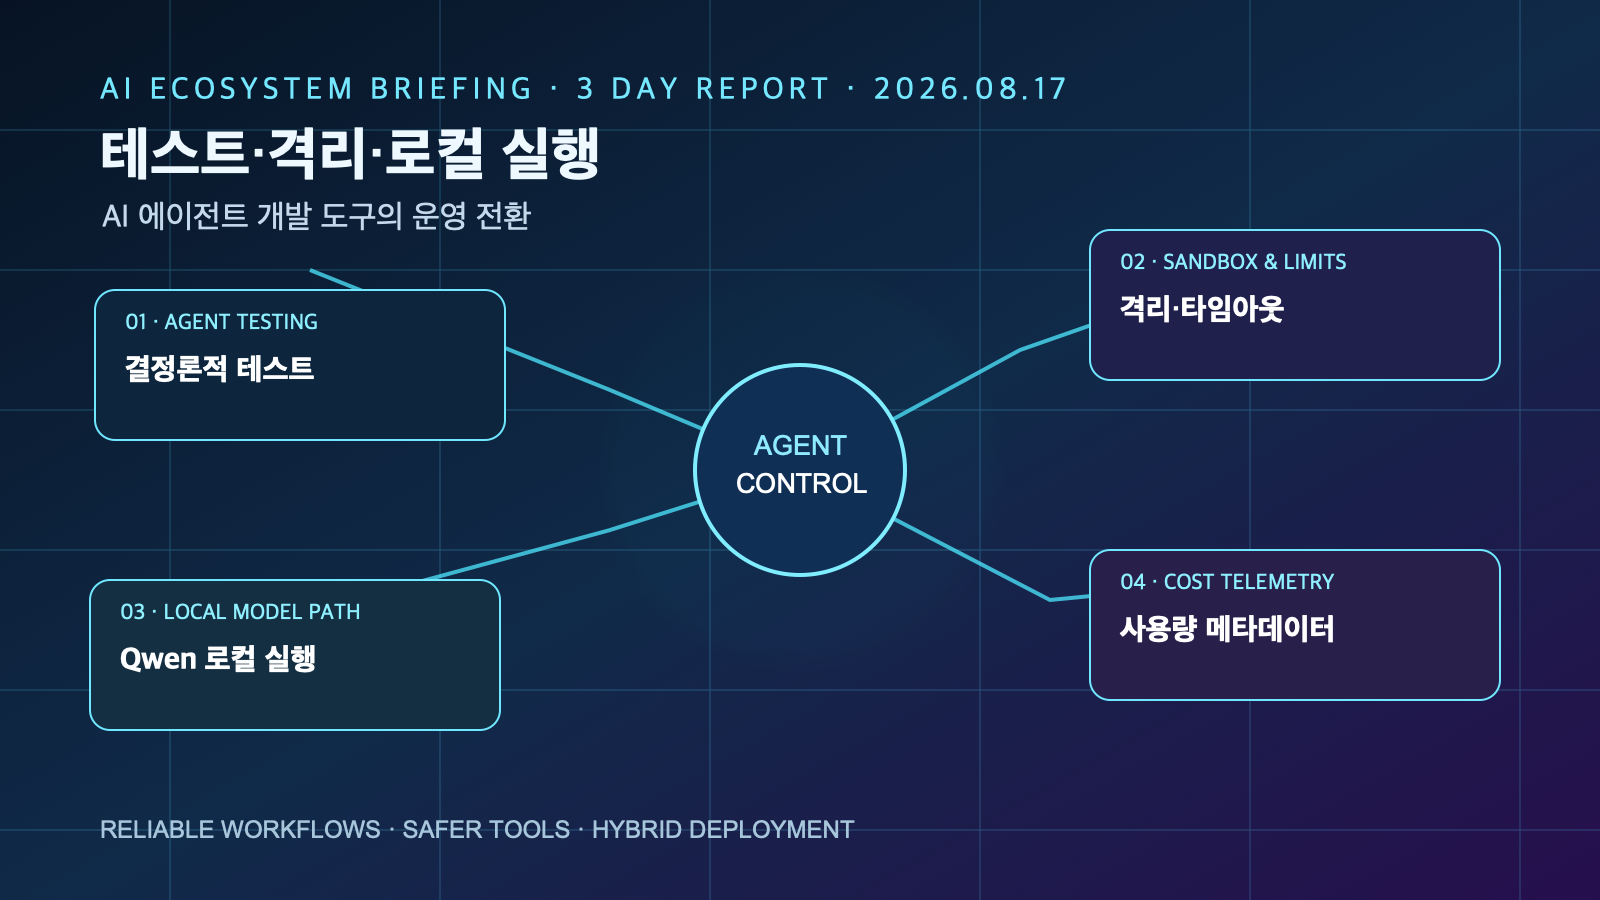
요약: 최근 72시간(2026년 8월 14일~17일 KST)의 AI/LLM·AI Agent 개발 도구 흐름은 에이전트를 더 잘 말하게 만드는 경쟁보다 테스트 가능성, 실행 격리, 로컬 배치, 비용·사용량 관측성을 제품 기능으로 만드는 방향에 집중됐다. AI 에이전트 운영의 다음 병목은 모델 선택 하나가 아니라, 실패 가능한 도구 호출을 어떻게 검증하고 제한하며 추적할지다.
핵심 답변: 지금 AI 에이전트 팀이 먼저 바꿔야 할 것은?
답: 프로덕션 에이전트는 모델 프롬프트만으로 관리할 수 없다. 이번 3일의 공식 릴리스는 결정론적 테스트, 호출 시간 제한, 실행 단위 샌드박스, 네트워크 통제, 사용자·비용 귀속, 로컬 모델 경로를 함께 다룬다. 개발팀은 새 모델을 바로 전면 적용하기보다 도구별 권한·타임아웃·승인 정책과 고정 입력 기반 회귀 테스트를 먼저 코드화하는 편이 안전하다.
- 확인된 사실: OpenAI Agents Python 0.21.0~0.21.1은 테스트 API, 호출 타임아웃, run-scoped 샌드박스 작업 디렉터리와 Docker 네트워크 비활성화 옵션을 공개했다.
- 확인된 사실: Claude Code는 사용자 식별 전달, Bash 메모리 cgroup, GitLab MR 워크트리 연결을 추가했다.
- 확인된 사실: Ollama는 로컬 Qwen 3.8 27B 지원과 OpenAI 호환 Responses API의 웹 검색을 포함한 릴리스를 냈다.
- 해석: 에이전트 품질 평가는 단일 답변의 정확도에서 실행 경계와 재현 가능한 운영 결과까지 확장되고 있다.
3일 결론: ‘에이전트 성능’에서 ‘에이전트 제어면’으로
8월 14일~17일 KST에 확인한 변화는 서로 다른 벤더의 작은 기능 목록처럼 보이지만, 공통점은 명확하다. 에이전트가 파일·셸·웹·MCP 같은 외부 도구에 연결될수록, 생성 모델의 능력만큼 누가 실행했고, 어디까지 실행했으며, 어느 비용으로 실패했는지를 제어하는 계층이 중요해진다. 아래 네 흐름은 공식 릴리스 노트에 근거한 사실이며, 실무 시사점은 별도로 구분했다.
흐름 1. 테스트와 샌드박스가 에이전트 SDK의 기본 기능으로 이동
OpenAI Agents Python 0.21.0·0.21.1: 결정론적 검증과 실행 경계
사실: v0.21.0 릴리스는 실제 공급자 요청 없이 Agent·Sandbox·Realtime·Voice 워크플로를 검증하는 agents.testing 계열 유틸리티를 추가하고 OpenAI Python 3.0 호환을 업데이트했다. 이어 v0.21.1은 모델 호출 timeout, 실행(run) 단위 샌드박스 작업 디렉터리, Docker 샌드박스의 네트워크 차단 옵션, 승인 결정 처리 보강을 포함했다.
시사점: 테스트에서 “같은 입력이면 같은 도구 계획과 정책 결과가 나오는가”를 만들고, 실행에서는 작업 공간·네트워크·시간을 분리하는 구성이 SDK 수준으로 내려오고 있다. 이것은 모델 응답을 스냅샷으로 저장하는 수준보다 한 단계 넓은 검증이다. 파일 생성, 코드 수정, 외부 API 호출을 하는 에이전트라면 테스트 더블로 도구 결과를 고정하고, 실제 환경에서는 도구를 최소 권한 샌드박스에 배치하는 것이 합리적이다.
흐름 2. 코딩 에이전트의 운영 책임이 사용자·자원 단위로 세분화
Claude Code 2.1.233: 비용 귀속과 runaway 명령 방어
사실: Claude Code v2.1.233(8월 14일 UTC)는 GitLab merge request URL을 --worktree와 agents 화면에서 지원하고, 게이트웨이 upstream에 로그인 사용자 식별 헤더를 전달할 수 있는 opt-in 설정을 추가했다. 또한 Linux의 Bash 도구 명령에 opt-in memory cgroup 제한(CLAUDE_CODE_TOOL_MEMORY_LIMIT)과 WebFetch 캐시 TTL 설정을 넣었다.
시사점: 사용자별 사용량 귀속은 단순 청구 기능이 아니라 책임 추적의 기초다. 메모리 제한은 긴 빌드·의존성 설치·잘못된 명령이 에이전트 세션 전체를 멈추는 위험을 낮춘다. 다만 식별 헤더 전달은 opt-in이므로, 조직은 프록시·로그에 어떤 개인/팀 식별자가 남는지와 보존 기간을 함께 검토해야 한다. ‘코딩 에이전트에게 터미널을 준다’는 결정을 권한·자원·감사 정책 없이 진행해서는 안 된다.
흐름 3. 로컬 모델과 에이전트 도구가 실험용 옵션을 넘어 배치 경로가 됨
Ollama 0.32.11~0.32.14: 로컬 실행, 웹 검색, 개발자 지시
사실: Ollama v0.32.11은 DeepSeek Harness와 Muse Code를 위한 ollama launch 진입점, OpenAI 호환 Responses API의 웹 검색 지원을 기록했다. v0.32.12는 Qwen 3.8 27B 및 Apple Silicon용 MLX 변형 지원을 추가했으며, v0.32.13은 Qwen 3.8의 developer instructions 지원을 명시했다. 최신 v0.32.14에는 llama-server WebP 이미지 변환과 Qwen 렌더러 호환 보완이 포함됐다.
시사점: 로컬 모델은 ‘클라우드의 완전한 대체’라는 주장보다, 데이터 민감도·지연시간·오프라인 요구에 맞춰 특정 도구 작업을 분리하는 하이브리드 경로로 보는 편이 정확하다. 웹 검색이 가능한 OpenAI 호환 인터페이스는 통합을 단순화하지만, 검색 결과는 비신뢰 입력이다. 검색 텍스트를 지시문으로 취급하지 않고, 도구 실행 전 승인·출처 허용 목록·출력 검사를 유지해야 한다.
흐름 4. 에이전트 관측성은 비용과 reasoning 흐름을 함께 보존하는 문제
LangChain 8월 14일 릴리스: SDK 호환과 메타데이터 보존
사실: langchain-openai 1.5.0은 OpenAI 3.0 SDK 지원을 추가했고, 1.5.1은 스트리밍 중 암호화된 reasoning 보존을 수정했다. 같은 날 langchain-openrouter 0.2.8은 usage chunk에서 비용 메타데이터와 provider 정보를 보존하는 변경을 포함했다.
시사점: 에이전트가 느리거나 비싸거나 예기치 않은 도구를 선택했을 때, 모델 텍스트만 저장하면 원인을 재현하기 어렵다. 요청 ID, 모델/공급자, 토큰·비용, 도구 호출, 승인 결과, timeout·재시도 이유를 하나의 trace로 묶어야 한다. 암호화된 reasoning처럼 민감할 수 있는 데이터는 무조건 수집하지 말고, 접근 제어와 보존 정책 하에서 필요한 범위만 다뤄야 한다.
개발자 액션 체크리스트
- 이번 주: 상위 3개 에이전트 플로우에 고정된 사용자 입력·도구 응답·정책 결정을 사용한 회귀 테스트를 추가한다. 성공 답변뿐 아니라 timeout, 거부, 부분 실패를 포함한다.
- 이번 주: 셸·파일·네트워크 도구마다 작업 디렉터리, 네트워크 접근, 최대 실행 시간, 메모리 상한, 사람 승인 필요 여부를 표로 명시한다.
- 다음 배포 전: 요청·도구·비용·승인 이벤트를 연결하는 trace 스키마를 정의하고, 사용자 식별 정보와 reasoning/검색 데이터의 마스킹·보존 기간을 검토한다.
- 하이브리드 검증: 민감 문서 요약 또는 반복 코드 작업 하나를 로컬 모델 경로로 시험하되, 품질·지연·비용·운영 부담을 같은 기준으로 클라우드 경로와 비교한다.
자주 묻는 질문 (AEO)
Q. 지금 바로 모든 에이전트를 로컬 모델로 옮겨야 하나?
A. 아니다. 이번 릴리스가 보여 주는 근거는 로컬 경로의 실용성이 커졌다는 점이지, 모든 워크로드의 우월성은 아니다. 데이터 경계가 명확하고 반복 가능한 작업부터 품질·지연·운영비를 측정해 단계적으로 적용하는 것이 낫다.
Q. 에이전트 테스트에서 가장 먼저 고정할 값은 무엇인가?
A. 사용자 입력, 도구의 성공·실패 응답, 승인 결정, timeout 조건이다. 모델 문장 자체보다 도구 호출 순서와 정책 위반 여부를 검사하면 릴리스 변경에도 더 안정적인 회귀 테스트가 된다.
Q. 웹 검색 기능이 있는 에이전트의 가장 작은 안전장치는?
A. 검색 결과를 신뢰할 수 없는 데이터로 분류하고, 그 안의 지시를 실행하지 않으며, 외부 변경 도구에는 별도 승인 단계를 두는 것이다. 출처 URL과 검색 시각도 trace에 남겨 재현성을 확보해야 한다.
주요 출처
- OpenAI Agents Python v0.21.1 release notes
- OpenAI Agents Python v0.21.0 release notes
- Claude Code v2.1.233 release notes
- Ollama v0.32.12 release notes
- LangChain OpenAI 1.5.0 release notes
범위: 2026년 8월 14일~17일 KST. 본문에서 ‘사실’은 연결된 공식 릴리스 노트에 근거하며, ‘시사점’은 해당 사실을 바탕으로 한 운영상 해석이다.
더 깊게 읽기: 실전 가이드
이 리포트는 최근 흐름을 빠르게 파악하기 위한 요약입니다. 실제 프로젝트에 적용할 때는 아래의 기준 글과 함께 확인하면 더 안전합니다.