

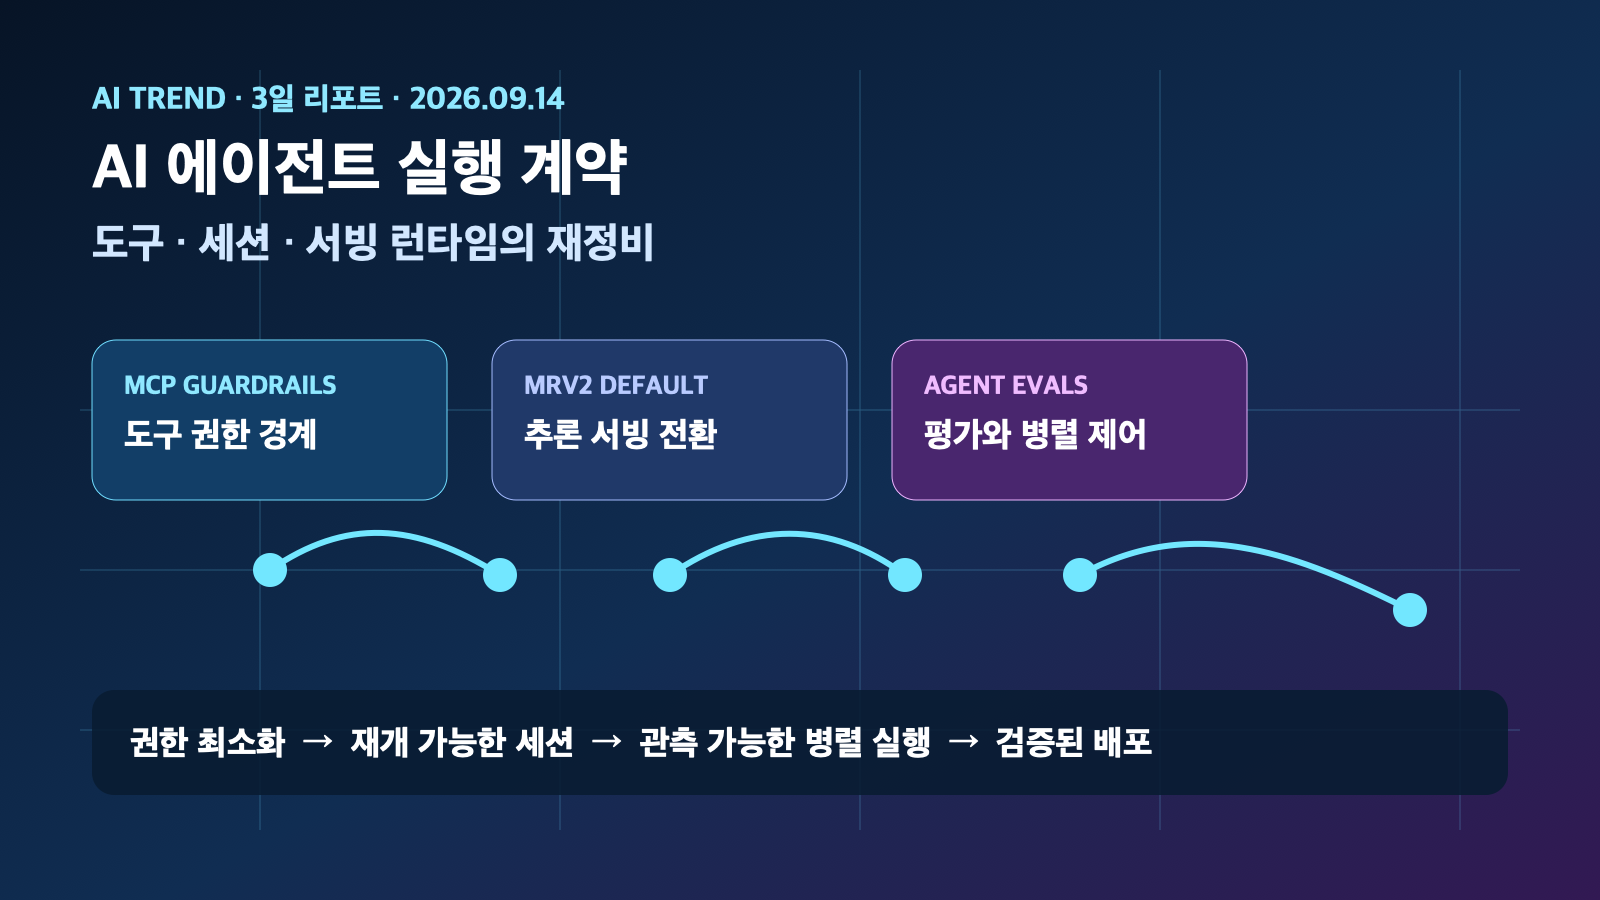
요약: 최근 72시간 AI/LLM·AI 에이전트 개발 도구 흐름은 ‘모델을 더 붙이는 일’보다 도구 경계, 세션 복구, 실행 권한, 서빙 런타임을 운영 가능한 계약으로 만드는 쪽에 집중됐다. 에이전트 SDK의 MCP·샌드박스 안전장치와 vLLM의 기본 런타임 전환, Claude Code의 평가·워크플로 제어가 같은 방향을 가리킨다.
핵심 답변
이번 3일의 결론은 명확하다. AI 에이전트를 제품에 넣을 때 경쟁력은 단일 모델의 성능보다 권한을 좁힌 도구 호출, 재개 가능한 세션, 관측 가능한 병렬 실행, 검증된 추론 서빙에 달려 있다. 새 버전을 즉시 전면 적용하기보다, 권한·상태·성능 회귀를 함께 측정하는 스테이징 경로를 먼저 만들어야 한다.
- 확인된 사실: OpenAI Agents SDK 0.22.1은 MCP 서버 단위 가드레일, Unix-local 격리, 빈 도구 인자 fail-closed 처리를 추가했고, 0.22.2는 UnixLocal 파일 API의 심볼릭 링크 경쟁 조건을 수정했다.
- 확인된 사실: vLLM 0.29.0은 Model Runner V2(MRV2)를 모든 모델의 기본값으로 전환하고 MRV1을 폐기 경로로 표시했다.
- 확인된 사실: Claude Code 2.1.269은 플러그인 평가·출력 스타일·에이전트 맵·워크플로 동시성 제어를, 2.1.270은 장시간 세션에서 읽기 전용 Git 명령이 권한을 재요청하던 회귀를 수정했다.
3일 결론: 에이전트 운영의 중심이 ‘능력’에서 ‘실행 계약’으로 이동
72시간 동안 확인된 업데이트는 서로 다른 제품에서 나왔지만 공통점이 있다. 에이전트가 장기 실행할수록 실패는 답변 품질보다 도구 호출, 파일 경계, 세션 상태, 병렬 작업 충돌에서 발생한다. OpenAI의 공식 Agents SDK 문서도 SDK를 사용할 때 세션·추적·가드레일·재개 가능한 승인 흐름을 제공한다고 설명한다. 이는 에이전트 루프를 애플리케이션 코드가 소유하되, 위험한 실행 지점은 명시적으로 통제해야 한다는 뜻이다. OpenAI Agents SDK 문서
실무 시사점(해석): ‘도구를 많이 연결한 에이전트’보다, 도구별 입력 스키마·승인·감사 로그·실패 재개 규칙이 분리된 에이전트가 배포와 장애 대응에 유리하다. 이는 공식 릴리스의 기능 묶음에서 도출한 운영적 해석이며, 특정 벤더의 성능 우위 주장과는 구분해야 한다.
흐름 1. MCP·로컬 실행: 가드레일과 파일 경계를 먼저 테스트
OpenAI Agents SDK 0.22.1~0.22.2
v0.22.1(9월 8일)은 웹 검색 도구의 이미지 결과, 출력 가드레일 차단 메시지 사용자화, MCP 도구에 대한 서버 전역 가드레일, 설정 가능한 Unix-local 환경 격리 등을 포함했다. 이어 v0.22.2(9월 9일)는 이미지 생성 도구 옵션 지원과 함께 UnixLocal 파일 API의 심볼릭 링크 경쟁 조건을 고치고 세션 압축 체인 재설정도 수정했다.
- 사실 → 도구 계층에 가드레일과 로컬 격리 옵션이 들어왔고 파일 API 보안 수정이 후속 배포됐다.
- 의미 → MCP 연결은 편의 기능이 아니라 실행 권한의 확장이다. 서버 전체 정책과 파일 경로 검증이 릴리스 노트 수준의 변경 대상이 됐다.
- 액션 → 연결한 MCP 서버마다 허용 도구·허용 도메인·쓰기 경로를 목록화하고, 심볼릭 링크·빈 인자·재시도 중복을 포함한 부정 테스트를 CI에 넣는다.
흐름 2. 추론 서빙: 기본값 전환은 성능 업데이트가 아니라 마이그레이션 이벤트
vLLM 0.29.0의 MRV2 기본화
vLLM 0.29.0(9월 9일)은 Model Runner V2를 모든 모델의 기본 러너로 전환했다. 릴리스는 MRV1을 deprecated로 보고 v0.32에서 제거를 목표로 하며, 일부 MRV2 기능 공백이 남아 있다고 명시한다. 또한 요청별 speculative decoding acceptance 통계, OpenAI 호환 API 보완, 오디오 입력 크기 제한 등도 포함했다.
- 사실 → 런타임 기본값과 CLI 사용 경로가 바뀌었고, 과거 러너는 폐기 방향이다.
- 의미 → 동일 모델·동일 프롬프트여도 캐시, 스케줄링, 지연시간, 지원 아키텍처가 달라질 수 있다. 단순 버전 범프가 아니다.
- 액션 → 운영 클러스터 전환 전 대표 모델별 TTFT·TPOT·오류율·메모리·스트리밍 호환성을 MRV1/MRV2에서 비교하고, `vllm serve` 경로와 롤백 이미지를 동시에 검증한다.
흐름 3. 코딩 에이전트: 병렬화보다 평가 가능성과 세션 신뢰성이 우선
Claude Code 2.1.269~2.1.270
Claude Code 2.1.269(9월 11일)은 `claude plugin eval`의 재현 가능한 점수·JSON/HTML 리포트, 출력 스타일 전환, VS Code 에이전트 맵, 워크플로 동시 에이전트 상한 설정을 추가했다. 다음 2.1.270(9월 12일)은 장시간 실행 후 읽기 전용 Git 명령이 예상치 않게 권한을 묻던 2.1.269 회귀를 수정했다.
- 사실 → 병렬 실행의 관찰·평가 도구가 보강되는 동시에, 권한 UX 회귀가 신속히 패치됐다.
- 의미 → 멀티 에이전트 도입의 병목은 ‘더 많은 하위 에이전트’가 아니라 작업 충돌, 승인 피로, 결과 재현성이다.
- 액션 → 플러그인/스킬 변경은 정답률만 보지 말고 권한 요청 수, 실패 후 재시도, 파일 충돌, 소요 시간을 함께 기록한다. 병렬 상한은 모델 속도가 아닌 리포지터리 쓰기 경합을 기준으로 정한다.
개발자 체크리스트
- 이번 주 안에 에이전트 도구별 읽기·쓰기·네트워크·배포 권한표를 작성하고 기본 거부 정책을 적용한다.
- 장기 작업에 대해 세션 재개, 취소, 중복 실행, 도구 타임아웃의 네 가지 실패 시나리오를 자동 테스트한다.
- vLLM 0.29.0 검토 시 MRV2 전환을 별도 변경 관리 항목으로 등록하고 지표 기반 롤백 기준을 합의한다.
- 코딩 에이전트는 병렬 수를 늘리기 전 플러그인 평가와 에이전트별 작업 로그를 팀의 PR 검토 흐름에 연결한다.
FAQ
지금 SDK·서빙 런타임을 바로 올려야 하나?
보안 수정이나 차단된 기능이 필요한 경우를 제외하면, 즉시 전면 전환보다 격리된 스테이징에서 권한·세션·성능 회귀를 확인한 뒤 점진 배포하는 편이 안전하다. vLLM은 MRV2 기본화와 MRV1 폐기 계획을 공개했으므로 호환성 점검을 미루지 않는 것이 좋다.
에이전트 평가에서 가장 먼저 볼 지표는?
작업 성공률만으로는 부족하다. 도구 승인 횟수, 실패 후 재개 성공률, 중복 쓰기, 파일/브랜치 충돌, 실행 시간과 비용을 같은 테스트 세트에서 함께 기록해야 실제 운영 위험을 판단할 수 있다.
주요 출처
- OpenAI Agents SDK 공식 문서
- OpenAI Agents Python v0.22.1 릴리스 / v0.22.2 릴리스
- vLLM v0.29.0 릴리스
- Claude Code v2.1.269 릴리스 / v2.1.270 릴리스
기준 시각: 2026년 9월 14일 KST. 본문은 최근 72시간에 공개된 공식 문서와 릴리스 노트를 기준으로 하며, 전망은 별도로 표시했다.
더 깊게 읽기: 실전 가이드
이 리포트는 최근 흐름을 빠르게 파악하기 위한 요약입니다. 실제 프로젝트에 적용할 때는 아래의 기준 글과 함께 확인하면 더 안전합니다.