

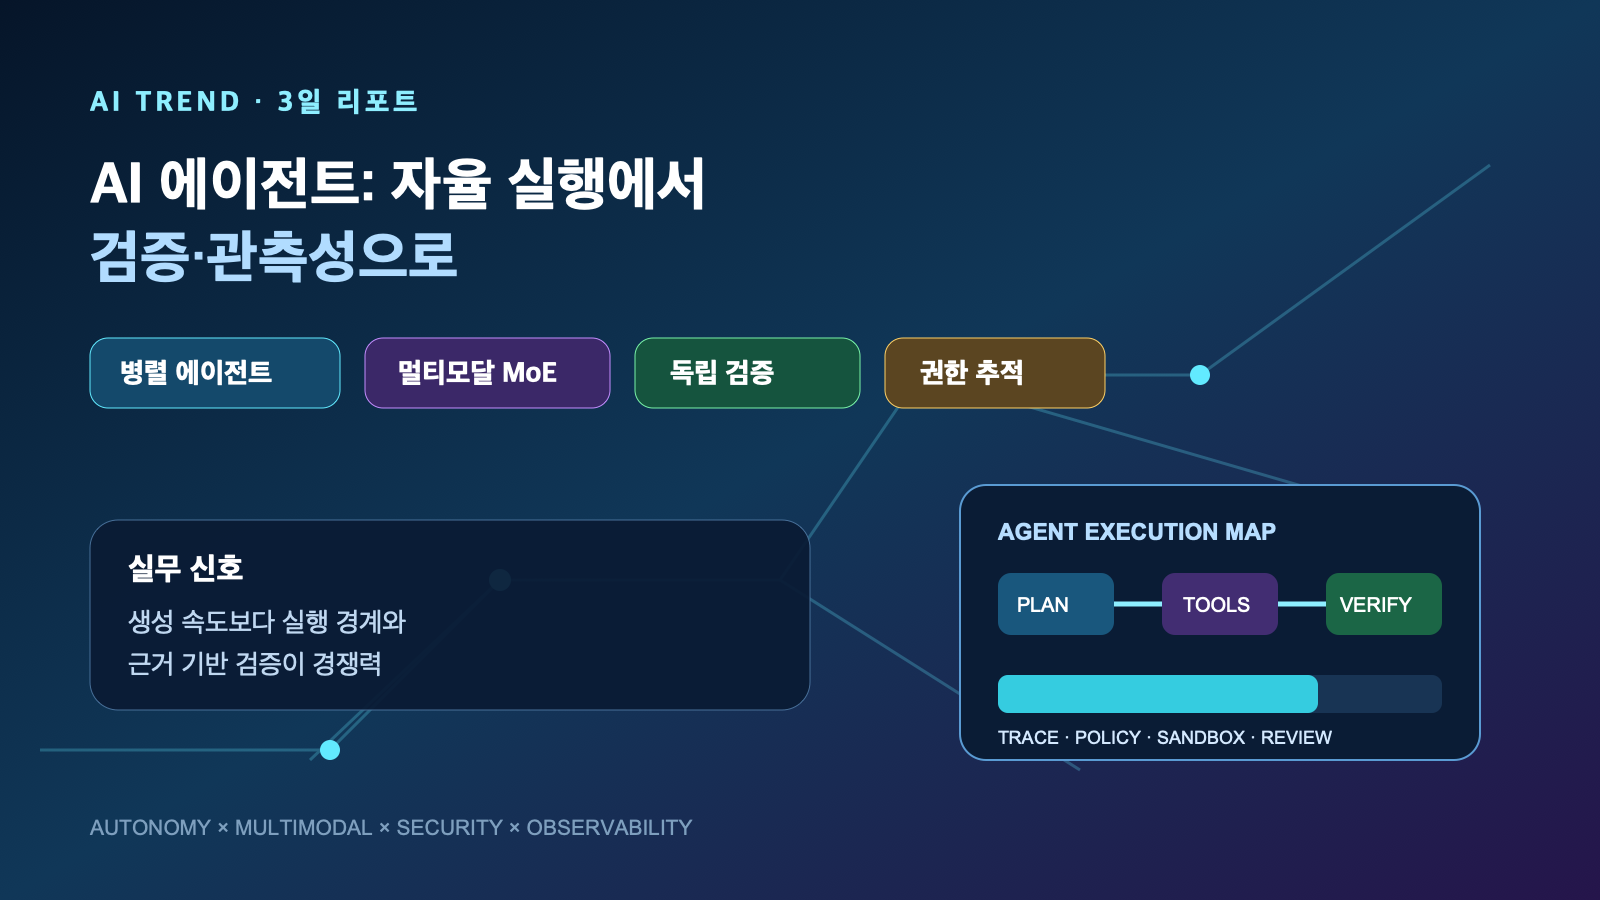
요약: 최근 72시간의 AI/LLM·AI Agent·개발자 도구 흐름은 에이전트의 자율 실행 확대와 그에 맞서는 검증·관측성·권한 통제의 제품화로 압축된다. AI 에이전트는 코드를 넘어 조사·설계·보안 업무를 잇기 시작했고, 실무 경쟁력은 더 긴 작업을 맡기는 능력보다 결과를 재현·검증·감사할 수 있는 실행 경계를 만드는 데 있다.
핵심 답변
무엇이 달라졌나? 이번 3일에는 코딩 에이전트의 실행 중 조향·병렬 처리·관측성 개선, 멀티모달 전문 에이전트 모델의 확대, 그리고 에이전트가 만든 코드와 행동을 독립적으로 검증하려는 보안·거버넌스 도구의 강화가 함께 확인됐다.
개발자는 무엇을 해야 하나? 에이전트를 단순 자동완성 도구가 아니라 제한된 권한을 가진 실행 주체로 다뤄야 한다. 작업 단위별 승인 경계, 도구 호출 로그, 독립 테스트·보안 검사, 롤백 가능한 배포를 하나의 기본 워크플로로 묶는 것이 우선이다.
3일 결론: “더 많이 생성”에서 “안전하게 끝까지 실행”으로
10월 13일~16일(KST) 발표와 릴리스를 종합하면 AI 에이전트 경쟁은 모델 성능만으로 설명하기 어렵다. Codex와 Claude Code의 최근 변경은 사용자가 실행 중인 에이전트를 더 빠르게 조향하고 관측하도록 개선한다. NVIDIA와 OpenAI의 사례는 문서·이미지·도구 사용, 그리고 개발 전후 단계를 하나의 작업으로 연결하는 방향을 보여준다. 반면 Snyk·Endor Labs·METR의 발표은 자율화가 커질수록 “누가 생성했는가”보다 “누가 검증했고 어떤 통제 아래 실행됐는가”가 중요해진다는 점을 분명히 한다.
아래는 확인된 사실과 그에 기반한 실무 해석을 구분한다. 벤더의 성능·보안 주장은 각 벤더가 공개한 평가 조건의 범위 안에서 해석해야 하며, 조직 도입 전에는 자체 저장소와 정책 환경에서 재검증해야 한다.
흐름 1. 코딩 에이전트는 “대기형 도구”에서 “조향 가능한 병렬 작업 환경”으로
확인된 사실
OpenAI Codex 0.163.0은 응답 도중 후속 지시를 보내 즉시 조향하는 기능, 독립적인 읽기 전용 도구 호출의 병렬 실행, 네트워크 프록시의 DNS 조회 전 권한 확인을 추가했다. 긴 에이전트 작업에서 사용자가 결과를 기다리기만 하는 대신, 중간에 목표를 수정하고 조사성 작업을 겹쳐 수행하도록 만드는 변화다.
Claude Code 2.1.301은 OpenTelemetry의 tool_decision 이벤트에 분류기 판정과 권한 모드를 넣고, 무인 재시도 모드가 너무 먼 사용량 리셋을 무한 대기하지 않도록 제한을 추가했다. 앞선 2.1.300도 API 요청의 캐시 수명별 토큰 지표와 GenAI semantic-convention 속성을 보강했다.
실무 해석
에이전트를 CI나 백그라운드 작업에 붙일 때 “성공/실패” 두 상태만 수집하면 원인 분석이 어렵다. 어떤 도구가 호출됐는지, 자동 분류가 차단했는지, 권한 규칙이 허용했는지, 재시도가 어디서 멈췄는지를 하나의 trace로 연결해야 한다. 병렬 읽기는 조사 속도를 높이지만 쓰기·배포·외부 시스템 변경은 병렬화보다 명확한 소유권과 직렬 승인 경계가 중요하다.
- 권장: 읽기 전용 탐색은 병렬 허용, 파일 수정·시크릿 접근·배포는 별도 승인 큐로 분리한다.
- 권장: task ID, git SHA, 도구 호출, 권한 판정, 테스트 결과, 산출물 경로를 실행 레코드로 남긴다.
- 주의: 무인 재시도에는 최대 시간·최대 토큰·최대 시도 횟수를 명시한다.
흐름 2. 전문 에이전트 모델은 텍스트·문서·차트·영상·도구 사용을 한 작업으로 묶는다
확인된 사실
NVIDIA는 Nemotron 3.5 Super VL을 오픈·커스터마이즈 가능한 멀티모달 에이전트용 모델로 소개했다. NVIDIA의 설명에 따르면 이 모델은 120B MoE 구조에서 토큰당 12B 파라미터를 활성화하며, 추론·지시 이행·툴 사용과 텍스트·이미지·문서·영상 이해를 결합한다.
OpenAI가 소개한 Amp 사례도 에이전트가 코딩뿐 아니라 무엇을 만들지 정하고, 페이지를 설계하고, 작업을 조율하는 개발 전후 단계로 범위를 넓히는 방향을 제시한다. 이는 일반화된 업무 자동화의 완성 선언이 아니라, 에이전트가 맡는 작업 단위를 더 길고 복합적으로 만드는 제품 흐름으로 봐야 한다.
실무 해석
멀티모달 모델 도입의 핵심 질문은 “모델이 문서를 읽는가”가 아니라 “우리의 문서·스크린샷·표·로그가 실제 의사결정에 필요한 근거로 유지되는가”다. PDF 표 해석, 대시보드 캡처, 인시던트 타임라인, 코드와 배포 설정을 한 작업으로 연결하려면 입력 정규화와 근거 링크가 필요하다. 모델이 답을 생성한 뒤 원본 위치로 돌아갈 수 없으면, 복합 입력의 장점은 감사 불가능한 요약으로 약해진다.
- 도입 체크: 실제 문서·이미지·로그 20~50개로 정확도, 근거 인용, 지연, 비용, 실패 양식을 함께 측정한다.
- 설계 원칙: 원본 파일 ID·페이지·표/이미지 좌표·추출 텍스트를 결과와 함께 보존한다.
- 배포 원칙: 복합 입력을 다루는 에이전트에는 데이터 분류와 파일별 접근 범위를 먼저 적용한다.
흐름 3. AppSec는 “자동 수정”보다 독립 검증과 데이터 경로 통제를 강화한다
확인된 사실
Snyk은 Evo Agentic AppSec을 발표하며 코드 스캔, 의존성 차단, 보안 검토, 수정, 시크릿 탐지를 역할별 에이전트로 제시했다. 발표에서 중요한 부분은 생성 에이전트가 자기 결과를 최종 판정하지 않는다는 구조다. 수정 에이전트가 운영 코드에 영향을 줄 수 있는 경우에는 승인 대기 상태로 두고 독립 검증을 거친다는 접근을 밝힌다.
Endor Labs의 AI SAST BYOK는 코드 분석용 모델 요청을 조직이 승인한 OpenAI·Azure OpenAI·Gemini·Vertex AI 계정으로 보내고, 지역·사용 기록·키 관리 요구사항에 맞추려는 기능이다. 이는 AI 기능이 개발 도구에 들어갈 때 모델 품질만큼 데이터 경로와 비용·감사 주체가 도입 조건이 된다는 사례다.
실무 해석
AI가 만든 PR을 빠르게 병합하려면 “에이전트가 테스트를 통과시켰다”는 자기 보고만으로는 부족하다. 생성 에이전트와 분리된 테스트 러너, SAST/SCA, 정책 검사, 사람이 읽는 변경 요약을 결합해야 한다. 패키지 설치를 에이전트가 제안하거나 수행한다면 이름 유사 패키지·환각된 패키지명·정책 외 레지스트리에 대한 사전 차단이 필요하다.
- 최소 게이트: lockfile, 신규 의존성, 시크릿·권한 파일, 인프라 코드 변경은 자동 병합 대상에서 제외한다.
- 독립 검증: 생성 모델과 다른 실행 환경에서 테스트·린트·SAST를 재실행하고 결과를 PR에 첨부한다.
- 공급망: 허용 레지스트리·패키지 서명·라이선스·취약점 정책을 프롬프트가 아니라 실행 레이어에서 강제한다.
흐름 4. 관측성은 로그 수집을 넘어 “모니터가 실제로 막는가”를 시험한다
확인된 사실
METR의 10월 14일 제안은 내부 AI 에이전트 통제를 평가할 때 모니터 커버리지, 모니터 시스템 취약점, 모니터 우회, 인간 검토 우회, 탐지되지 않은 행동의 영향이라는 다섯 질문을 제시한다. 모든 행동을 로그에 남기는 것만으로 충분하지 않으며, 실제로 어떤 경로가 모니터링에서 빠지는지와 경고가 인간 대응까지 이어지는지를 검증해야 한다는 점을 강조한다.
실무 해석
첫 단계는 에이전트 실행 경로의 목록을 만들고 고위험 경로부터 누락 여부를 확인하는 것이다. 브라우저 자동화, 사내 API, 클라우드 CLI, 배포 토큰, 고객 데이터 조회는 각각 다른 권한·로그·승인 체계를 가질 수 있다. 하위 에이전트 호출과 작업 재개 경로도 관측 대상에 포함해야 한다.
개발자 액션 체크리스트
- 이번 주: 에이전트 도구를 읽기·쓰기·외부 변경으로 분류하고 외부 변경에는 사람 승인 또는 정책 기반 차단을 붙인다.
- 이번 주: trace에 모델/버전, 권한 판정, 도구 입력의 안전한 요약, 결과, 테스트 상태를 남긴다. 비밀값과 원문 민감 데이터는 로그에 넣지 않는다.
- 다음 스프린트: 대표 작업 10개로 평가 세트를 만들고 성공률뿐 아니라 근거 인용률·롤백률·비용·재시도 횟수를 측정한다.
- 배포 전: 새 패키지·인프라·권한 변경은 독립 스캐너와 정책 엔진을 통과해야만 병합되게 한다.
짧은 Q&A
Q. 코딩 에이전트의 병렬 실행을 바로 늘려도 될까?
A. 읽기·조사 작업은 병렬화 이점이 크다. 파일 수정, 배포, 고객 데이터 접근처럼 외부 상태를 바꾸는 작업은 작업 큐·권한 범위·승인 단계를 분리한 뒤 확대하는 편이 안전하다.
Q. 멀티모달 모델 하나로 기존 파이프라인을 대체해야 할까?
A. 아니다. 먼저 문서·표·이미지 입력이 필요한 특정 업무를 선택하고, 원본 근거를 보존하는 평가로 품질과 비용을 확인해야 한다. 단일 모델 통합은 문맥 전달 비용을 줄일 수 있지만 데이터 분류와 검증 체계를 대신하지는 않는다.
Q. 에이전트 보안의 가장 작은 시작점은 무엇인가?
A. 도구 권한 최소화, 외부 변경 전 승인, 생성 모델과 분리된 검증, 추적 가능한 실행 로그 네 가지다.
주요 출처
- OpenAI Codex 0.163.0 release notes
- Anthropic Claude Code 2.1.301 release notes
- NVIDIA Nemotron 3.5 Super VL
- OpenAI: Amp beyond coding
- Snyk: Evo Agentic AppSec
- METR: control assessment proposal
- Endor Labs: BYOK for AI SAST
더 깊게 읽기: 실전 가이드
이 리포트는 최근 흐름을 빠르게 파악하기 위한 요약입니다. 실제 프로젝트에 적용할 때는 아래의 기준 글과 함께 확인하면 더 안전합니다.